Vascend
HorizonVascend IDEVascend CLICommunityBenchmarkContacto
AccederÚnete a Discord
NoticiasVídeosCursosStackProyectosDiscord
Community

AI Tools26 oct 2026Artículo en italiano

EAGLE-4, lo speculative decoding che si adatta al carico
EAGLE-4, lo speculative decoding che si adatta al carico
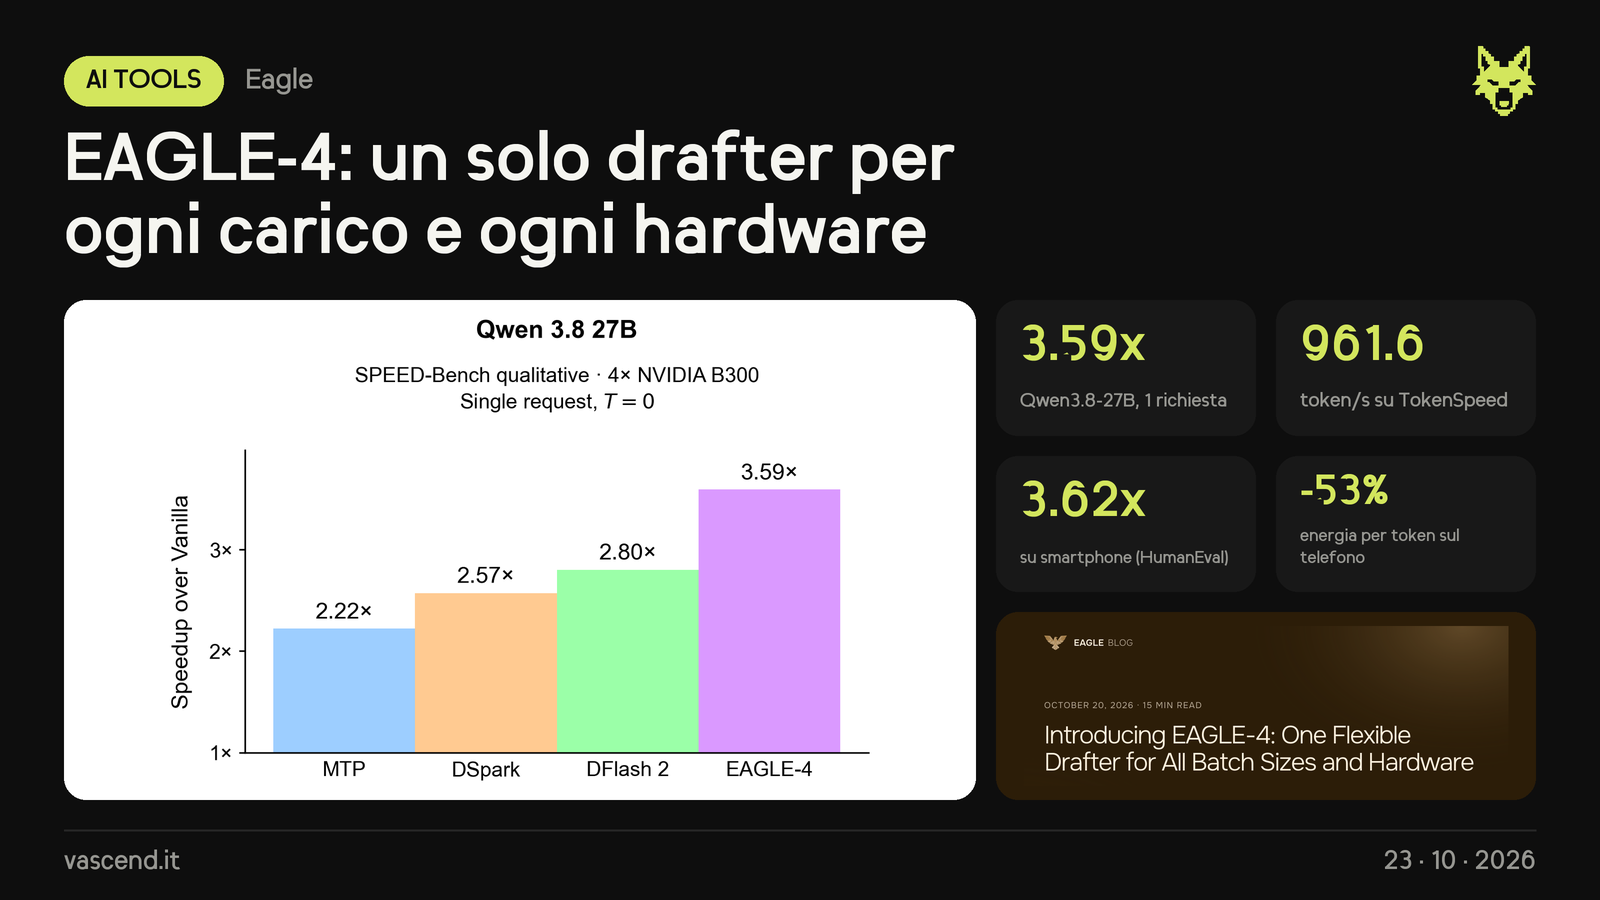
  • Eagle rilascia EAGLE-4: un solo drafter addestrato per ogni modello adatta l'albero di speculative decoding a numero di richieste, hardware e carico, e l'output resta identico a quello del modello originale.
  • Su Qwen3.8-27B (4× NVIDIA B300, TP4, T=0) arriva a 863.8 token/s con una richiesta, 3.59x il decoding normale (240.5), e a 28.340 token/s aggregati con 512 richieste (1.34x), davanti a DFlash 2 e DSpark. Su TokenSpeed tocca 961.6 token/s. Su Nemotron 3.5 Super VL fa 2.74x con una richiesta e 1.69x a 512; su una AMD MI350X 3.49x.
  • Funziona anche su CPU e su uno smartphone senza root: con Gemma-4-E2B a 4 bit 3.62x su HumanEval e -53% di energia per token. EAGLE-Harness misura i costi e sceglie profondità e larghezza dell'albero; l'Efficient LM Head taglia fino al 55% la latenza di ogni passo del drafter.
  • Si integra con SGLang, vLLM e TokenSpeed; pesi del drafter su Hugging Face. Il codice è pubblico ma con licenza "source available", non open source.
Fuentes

  • Blog ufficiale
  • GitHub EAGLE-4
  • Paper PDF
  • Sito eagle.ai
  • Thread X + video
NVIDIAHugging FaceOpen source

CompartirWhatsAppTelegramXLinkedInFacebook

Comentar en Discord

Cuéntanos qué piensas en #community-chat, con los demás miembros.

  • #ai-newslas noticias, al momento
  • #community-chatse habla de todo
  • #help-n-questionspreguntas y ayuda
  • #your-productslos proyectos de los miembros
Únete al Discord

14 en línea · 44 miembros

💡Sugiere una noticia

Más noticias

AI Tools26 oct 2026Liquid RIPL, l'AI generativa dentro la singola richiestaLiquid AI presenta RIPL (Real-time Inference Pipeline), un motore di inferenza a latenza bassissima per mettere i suoi modelli LFM direttamente nel percorso di una richiesta in tempo reale:…AI Tools26 oct 2026DeepInfer, DeepSeek apre il suo motore di inferenzaDeepSeek ha pubblicato il 20 ottobre DeepInfer, il framework di inferenza che usa internamente per far girare DeepSeek-V4.1-Flash su larga scala. È open source con licenza Apache 2.0 e ha già…AI Tools26 oct 2026Hostinger Agent diventa un unico agenteHostinger ha riprogettato Hostinger Agent: Kodee e gli agenti AI di Hostinger ora sono un solo agente, che sceglie da solo strumenti, skill e conoscenze per ogni richiesta
HorizonVascend IDEOlympusTalosCursosCommunityBenchmark
DiscordGitHubXHablemosAvisos legalesPrivacidadCookiesUso de datosSeguridad
© 2026 Vascend Technologies · VAT IT04911550616
ascend