Community
Ming-3.0, lo stack vocale open source di Ant Group
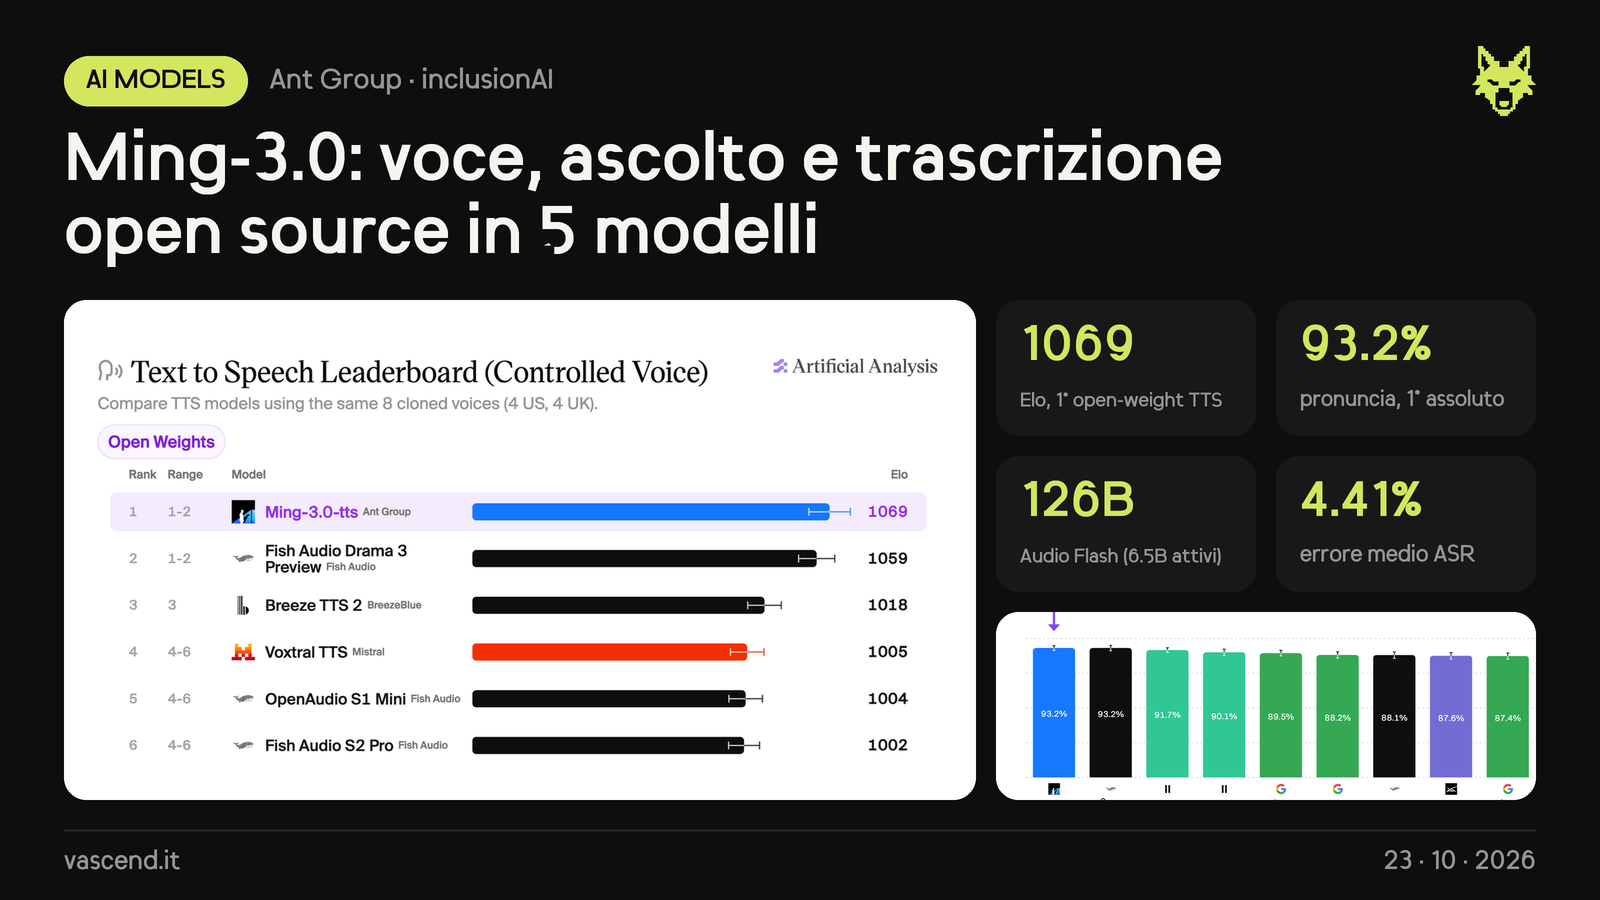
- inclusionAI (Ant Group) rilascia Ming-3.0: 5 modelli open in 3 famiglie per la voce. TTS (0.5B denso e Tiny MoE 7.9B con 1.3B attivi), Audio (Flash 126B con 6.5B attivi e Tiny 9.3B con 2.7B attivi) e ASR (Tiny 8.6B).
- Il TTS è primo fra i modelli open-weight nella classifica Artificial Analysis Controlled Voice (1069 Elo) e primo in assoluto per robustezza della pronuncia (93.2%). Clona una voce o la crea da una descrizione, segue istruzioni libere su emozione, velocità e tono, inserisce risate e sospiri con 14 tag. Parla 7 lingue più cantonese e sichuanese.
- Audio riconosce il parlato anche con rumore e più persone, capisce registrazioni lunghe, suoni, ambienti e musica, ragiona sull'audio e può rispondere a voce. ASR trascrive cinese e inglese con 15 dialetti cinesi, usa hotword e contesto, con un errore medio del 4.41% contro il 5-6.5% di Qwen3-ASR e FireRed.
- Pesi su Hugging Face e ModelScope, con supporto SGLang e vLLM-Omni. L'idea è chiudere il giro: ascoltare, capire, agire, parlare.