Community
NVIDIA: agli agent LLM non serve il long context
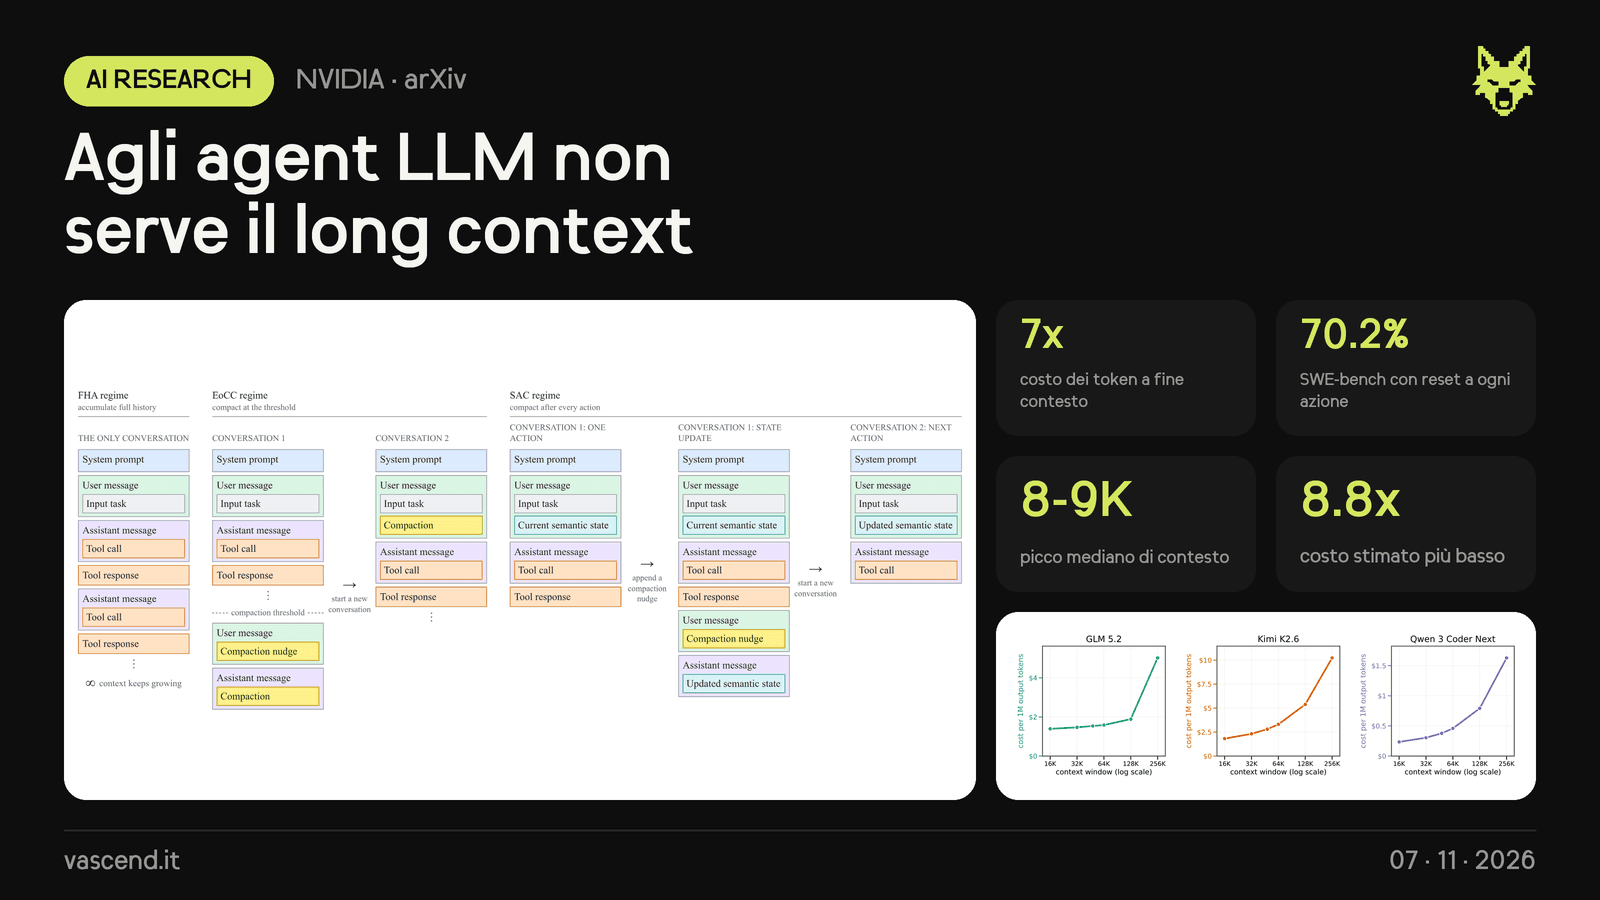
- Nel paper "You don't need long context" i ricercatori NVIDIA partono da un costo nascosto: i token generati in fondo a un contesto lungo costano di più, fino a 7x sui modelli open weight. Con la compaction frequente (l'agent scrive una nota di passaggio sul lavoro fatto e rilegge gli input solo dove serve) i contesti restano corti, circa 16-50K token, e l'accuratezza tiene su task long-horizon e long-input.
- Su 6 benchmark long-horizon Claude Opus 4.5 resta tra −3.7 e +5.6 punti rispetto alla storia completa, con costi stimati fino a 8.8x più bassi. Spingendo al limite, la Single-Action Compaction riparte da zero dopo ogni azione: 70.2% su SWE-bench Verified contro 70.0% con tutta la storia, meglio anche su Terminal-Bench, con un picco di contesto mediano di 8-9K token invece di 27-32K (fino a 130-200K).
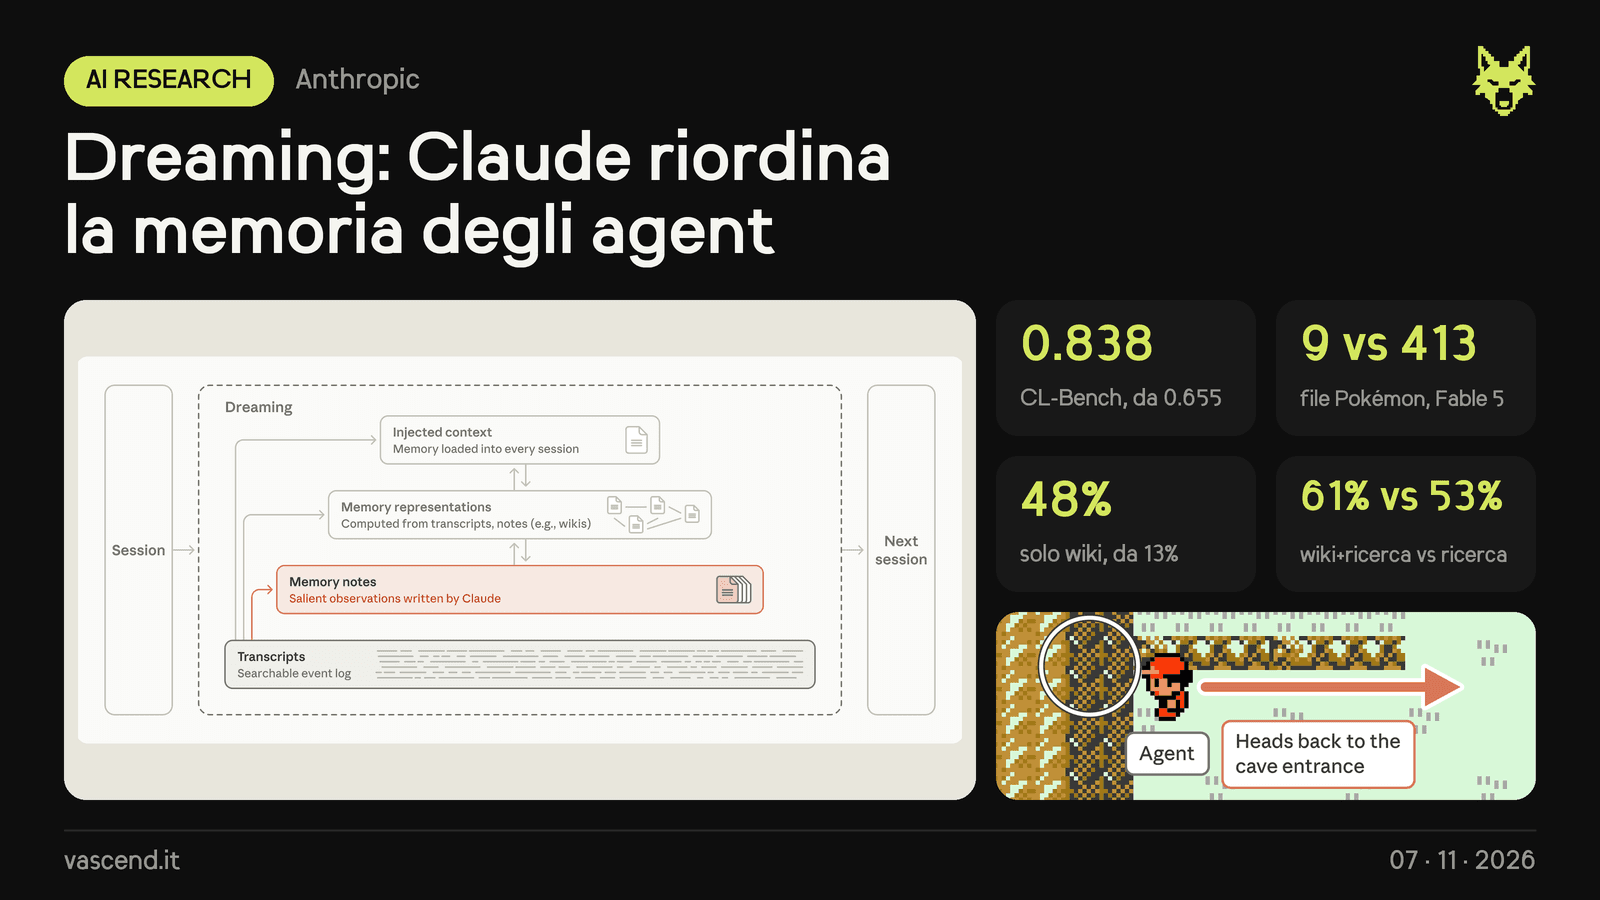
- Da qui l'idea dei Semantic State Space Models (SSSM): modelli post-addestrati per leggere e aggiornare tra un passo e l'altro uno stato compatto scritto in linguaggio naturale, al posto dell'intera trascrizione.