Spark-X2.6-1.7B, agente on-device con vLLM dal day-0
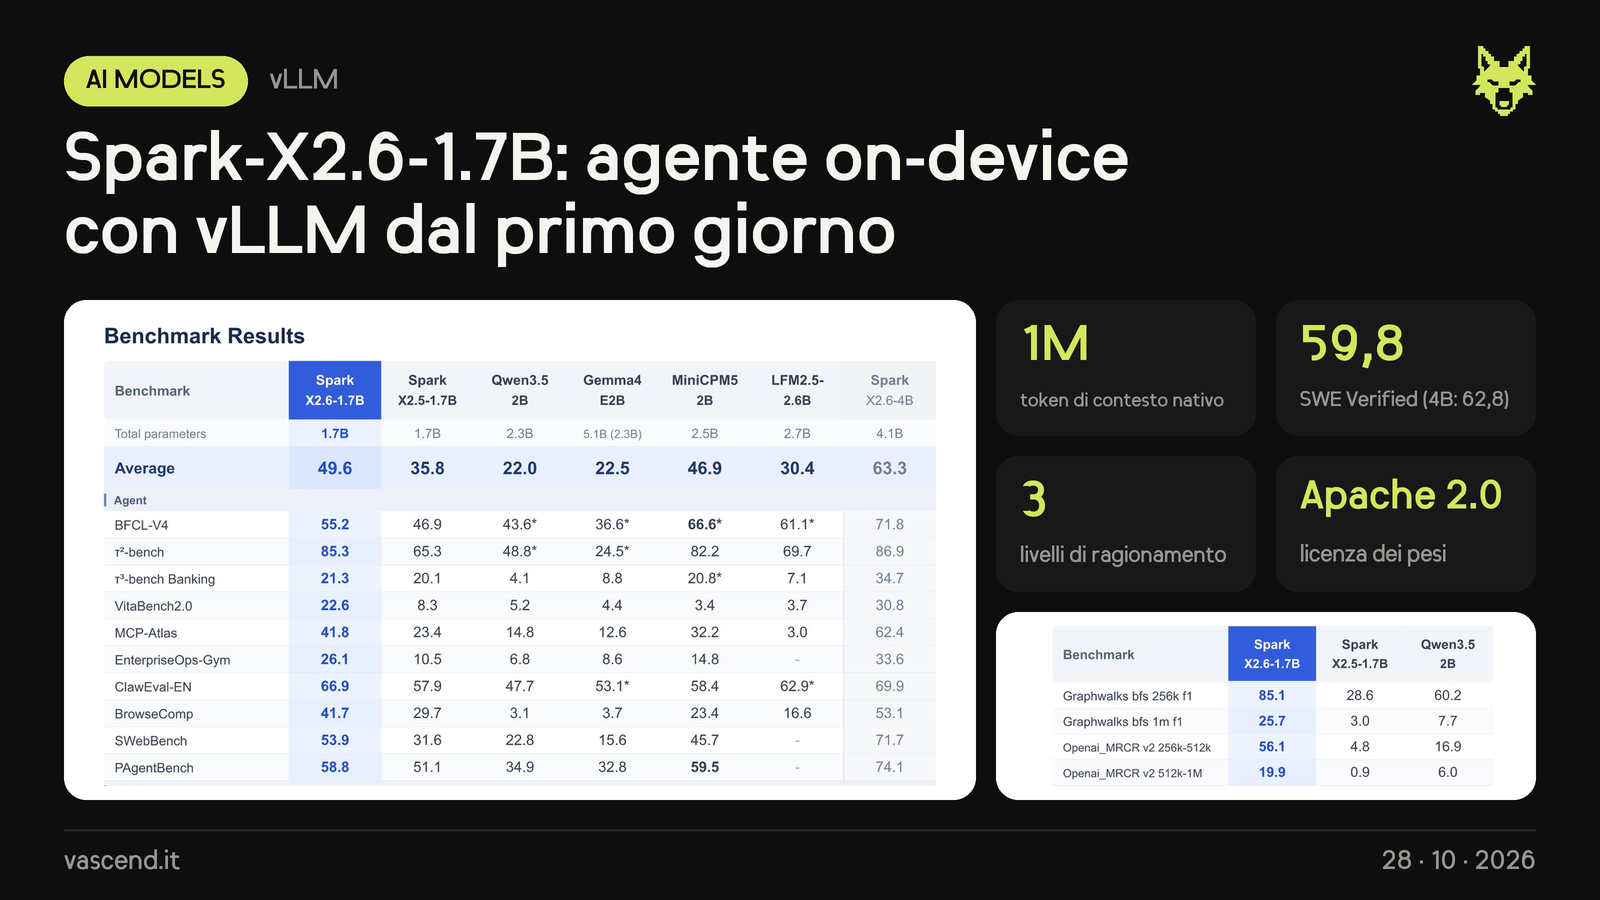
SparkLLM ha rilasciato Spark-X2.6-1.7B, un modello compatto da 1,7 miliardi di parametri pensato per girare sui dispositivi e lavorare come agente. Ha un contesto nativo di 1 milione di token, tre livelli di ragionamento regolabili e, secondo i test dell'azienda, resta vicino al fratello maggiore da 4B su SWE Verified (59,8 contro 62,8) e τ²-bench (85,3 contro 86,9). vLLM lo supporta dal primo giorno, anche sulle NPU Ascend.
Cosa c'è di nuovo
- È il secondo modello della serie Spark-X2.6, dopo il 4B. L'architettura è identica a Spark-X2.5-1.7B: i progressi vengono tutti da un post-training migliore.
- Il contesto arriva a 1.048.576 token. Gli strati si alternano: tre su quattro guardano una finestra scorrevole di 512 token, uno su quattro legge tutto il testo.
- Il ragionamento ha tre livelli: none, low e high. Si sceglie quanto far pensare il modello in base a qualità, tempi e costi.
- I pesi sono su Hugging Face con licenza Apache 2.0, anche in versione Base, FP8, INT8, INT4 e GGUF.
I numeri
Tutti i test sono in modalità ragionamento, col livello high per i modelli Spark. Rispetto a Spark-X2.5-1.7B:
- SWE Verified passa da 28,3 a 59,8
- τ²-bench passa da 65,3 a 85,3
- la media dei benchmark sale da 35,8 a 49,6, contro 46,9 di MiniCPM5-2B e 22,0 di Qwen3.5-2B
Sul contesto lungo il salto è netto, ma il limite si vede: Graphwalks a 256k token fa 85,1, a 1M scende a 25,7. Alcuni punteggi dei concorrenti sono presi dalle loro schede pubbliche e due benchmark (SWebBench e PAgentBench) sono interni e non ancora pubblici.
Nei test di velocità dell'azienda (Mac M5 Pro e RTX 4090, pesi a 4 bit) è il più rapido in generazione ai contesti corti; con il fork ottimizzato di llama.cpp il vantaggio vale a tutte le lunghezze provate sulla 4090.
Come provarlo
- vLLM su GPU NVIDIA: immagine ufficiale
vllm/vllm-openai:latestcon l'opzione--trust-remote-codee il chat template incluso nel modello. - vLLM-Ascend su NPU Ascend (A2, A3 e 950DT): immagini nightly più Spark-plugin, che registra il modello e il parser delle chiamate agli strumenti senza toccare il codice di vLLM.
- In locale:
ollama run SparkLLM/Spark-X2.6-1.7B(Ollama 0.34.1 o successivo), LM Studio 0.4.0 o successivo, llama.cpp dalla build b10828, MLX su Apple silicon con Spark-MLX-LLM. - Funziona anche con SGLang, Transformers 4.57.1 e Unsloth Studio.
Cosa significa
Un modello sotto i 2 miliardi di parametri che si avvicina al 4B su compiti da agente e da programmazione apre ad assistenti che lavorano in locale, su un Mac o un PC con GPU, senza mandare i dati in cloud. Con vLLM e vLLM-Ascend pronti da subito si può mettere anche su server, sia con GPU NVIDIA sia con chip Ascend. I numeri restano quelli dichiarati da SparkLLM: servono test indipendenti per confermarli.