Gemini 4 Carbon, Google passa in testa
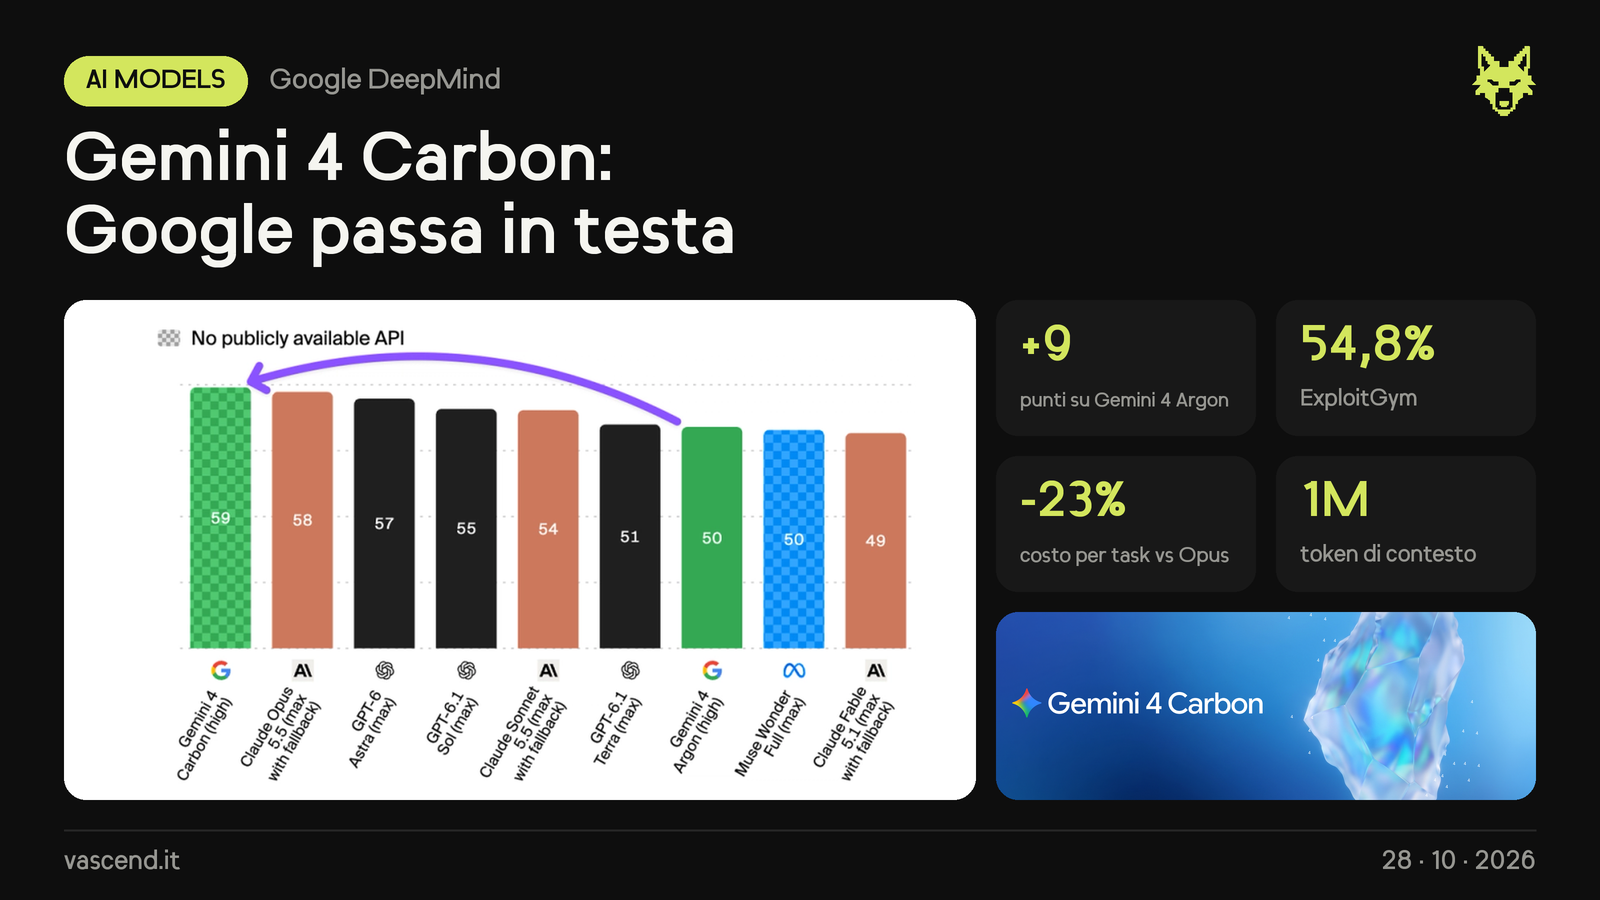
Google DeepMind ha presentato il 28 ottobre Gemini 4 Carbon, il suo modello più forte, appena due settimane dopo Gemini 4 Argon. È pensato per i lavori lunghi e per la sicurezza informatica: secondo Google può lavorare per giorni su un problema senza arrendersi ai vicoli ciechi, per esempio per trovare la causa di un bug nascosto in una codebase grande e scriverne la correzione. Sull'Intelligence Index v5 di Artificial Analysis, uscito il giorno prima, prende subito il 1° posto con 59 punti. Per ora però lo usano solo alcuni esperti di sicurezza scelti da Google.
Dove entra in classifica
Carbon entra in cima e tutti gli altri modelli scendono di un posto.
- Gemini 4 Carbon (high): 1°, con 59
- Claude Opus 5.5 (max): dal 1° al 2°, con 58
- GPT-6 Astra (max): dal 2° al 3°, con 57
- GPT-6.1 Sol (max): dal 3° al 4°, con 55
- Claude Sonnet 5.5 (max): dal 4° al 5°, con 54
- Gemini 4 Argon (high): dal 6° al 7°, con 50, cioè 9 punti sotto Carbon
I primi tre posti ora sono di tre laboratori diversi, racchiusi in 2 punti. Carbon fa il miglior punteggio in 4 delle 9 prove dell'indice: HLE-Diamond, Terminal-Bench-Science, AA-Omniscience e AutomationBench-AA, cioè ragionamento complesso, conoscenza e scienza. Non è primo invece nel coding e nel lavoro d'ufficio:
- su AA-Briefcase fa 1609 Elo, 126 punti più di Argon ma sotto Kimi K3.1 Pro (1678)
- nel Coding Agent Index, usato con Antigravity CLI, fa 59, a 3 punti da Claude Code con Opus 5.5 (62)
- su AA-Omniscience v1.1 fa 54, con il 58% di risposte giuste e solo l'11% di risposte inventate, il secondo dato più basso dopo Argon
I numeri di Google
Nella tabella pubblicata da Google, Carbon batte GPT-6 Astra e Claude Opus 5.5 in quasi tutte le prove:
- Terminal-Bench 4.0: 65,2%, contro il 59,6% di Opus 5.5 e il 59,1% di GPT-6 Astra
- Agents' Last Exam v1.1 (uso del computer): 77,4%, contro il 73,1% di GPT-6 Astra
- GraphWalks (contesto lungo, da 256K a 1M token): 96,2%, contro il 71,8% di GPT-6 Astra e il 66,8% di Opus 5.5
- Vending-Bench 2: chiude con 16.484 $ in cassa, contro i 15.515 $ di GPT-6 Astra e i 9.235 $ di Opus 5.5
- RiemannBench (matematica): 80%, contro il 72% di GPT-6 Astra
- Resta dietro su FrontierSWE 2 (61,2%, contro il 65,5% di GPT-6 Astra e il 62,3% di Opus 5.5) e su OSWorld-2.1 (81,5%, contro l'87,2% di Opus 5.5)
La sicurezza informatica
Google lo presenta come il modello per tutto il lavoro di difesa: trovare le vulnerabilità, capire quali si possono sfruttare davvero e correggerle.
- Trovare: 88,2% su SEC-bench Pro, contro l'85,4% di GPT-6 Astra e l'83,4% di Argon
- Verificare: 54,8% su ExploitGym, contro il 42,4% di GPT-6 Astra e il 34,5% di Opus 5.5
- Correggere: 71% su CWE-bench di Collinear, contro il 68% di Argon e di GPT-6 Astra
- Secondo il team di Chrome, nello scrivere patch di qualità Carbon è andato più di 10 volte meglio di un grande modello di un altro laboratorio, che Google non nomina
- Wiz lo mette in testa nei suoi test di penetration testing sul web
Sulla sicurezza del modello stesso Google riporta lo 0% di attacchi riusciti sul test di prompt injection indiretta di Gray Swan, la metà delle affermazioni senza fondamento rispetto ad Argon e quasi l'80% in meno di comportamenti fuori controllo segnalati negli ambienti di coding reali.
Costi
- Al lancio costa come Argon: 2 $ per milione di token in ingresso e 10 $ in uscita, con l'input in cache scontato del 95%. Finito il periodo di lancio si passa a 4 $ e 20 $, ma per ora non c'è una data di fine dello sconto.
- Per Artificial Analysis un task dell'indice costa 7,76 $: circa il 23% in meno di Claude Opus 5.5 (10,04 $), ma circa 1,2 volte GPT-6 Astra (6,25 $). Usa 123.000 token di output a task, il 29% in meno di Opus 5.5 (173.000).
- Ha un contesto da 1 milione di token, legge testo, immagini, voce e video e risponde in testo.
Chi può usarlo
Da questa settimana Carbon va solo a un gruppo di esperti di difesa informatica. Poi Google lo aprirà poco per volta ad altri partner di fiducia con il Fairwind Program. Per sviluppatori, aziende e utenti non c'è ancora una data: Google dice solo che arriverà il prima possibile. Non c'è un'API pubblica, ed è per questo che nei grafici di Artificial Analysis la barra di Carbon è a quadretti.
Cosa significa
In due settimane Google è passata da Argon, 6° nella classifica v5, al primo posto con Carbon, e oggi i tre laboratori più forti stanno in due punti. Il vantaggio di Carbon è nel ragionamento, nella scienza e nei compiti lunghi, mentre per gli agenti di coding Claude Code con Opus 5.5 resta davanti. Molti dei numeri sulla sicurezza vengono da Google e, fuori dai partner scelti, per ora nessuno può provarlo.