Intelligence Index v5: OpenAI risale, Kimi scende
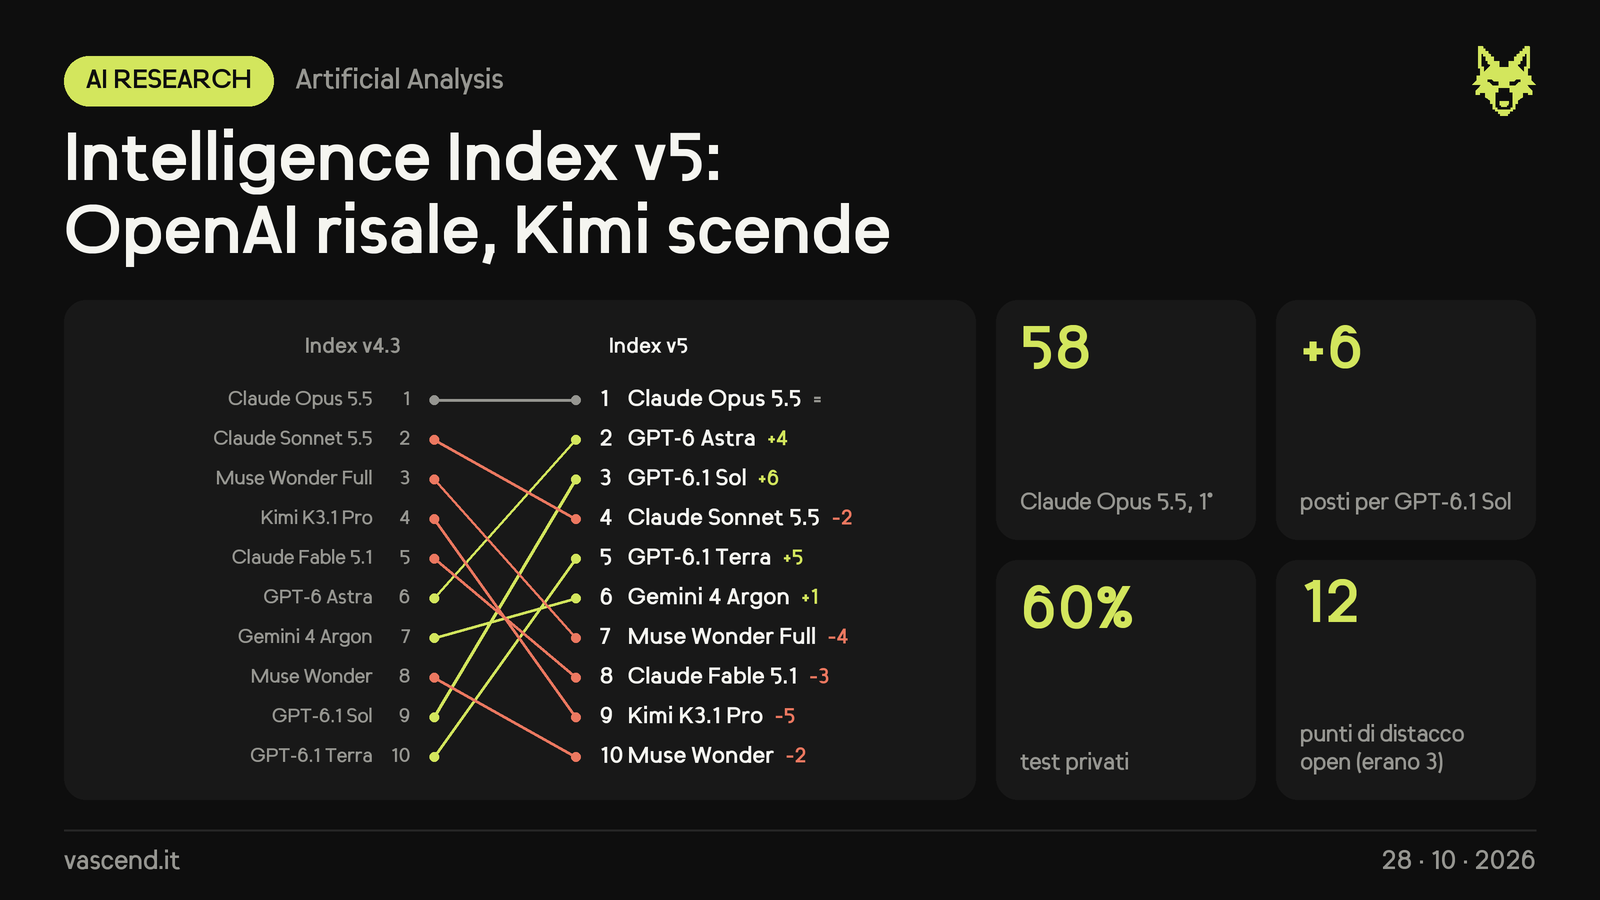
Artificial Analysis ha lanciato il 27 ottobre l'Intelligence Index v5, il cambio più grosso dell'indice da quando è uscita la v4 a gennaio. La novità principale è che il 60% del punteggio viene ora da test con domande private o risposte nascoste: i modelli non possono averle viste durante l'addestramento, quindi il voto misura meglio quello che sanno fare davvero. Il risultato è una classifica rimescolata: Claude Opus 5.5 resta primo, ma OpenAI risale in blocco e Kimi K3.1 Pro, che una settimana fa era 4°, scivola al 9° posto.
Cosa cambia nell'indice
L'indice resta diviso in quattro aree, ognuna vale il 25%: lavoro d'ufficio, coding, scienza e conoscenza generale. Cambiano però le prove dentro le aree.
- FrontierCode 2.0 (nuovo, 15%): il benchmark privato di Cognition con 132 task in repository open source veri. Un tentativo conta solo se il maintainer accetterebbe la modifica: basta un controllo bloccante fallito e il punteggio è zero
- Terminal-Bench-Science (nuovo, 15%): 70 task di ricerca scientifica da svolgere in un terminale, curati da esperti. Il task passa solo se passano tutti i suoi test
- HLE-Diamond (10%) prende il posto di Humanity's Last Exam: 1.000 domande ripulite, metà di ragionamento e metà di conoscenza
- AA-Omniscience v1.1 (15%): tolte le domande ormai troppo facili o pubbliche, aggiunte di nuove e corrette quelle ambigue. Conta sia l'accuratezza sia quanto il modello evita di inventare
- CritPt v2 (10%): 40 domande di fisica a livello di ricerca, le più difficili, risolte con un ambiente Python offline
- Restano AA-Briefcase, AutomationBench-AA, GDP.pdf e Terminal-Bench 4.0
- Escono GDPval-AA v2.1, SciCode e AA-LCR v1.1
Come cambia la classifica
Abbiamo confrontato la classifica v4.3 con quella v5, contando un posto per modello alla massima intensità di ragionamento.
- Claude Opus 5.5: resta 1°, con 58 punti
- GPT-6 Astra: dal 6° al 2° (+4), con 57
- GPT-6.1 Sol: dal 9° al 3° (+6), con 55
- Claude Sonnet 5.5: dal 2° al 4° (-2), con 54
- GPT-6.1 Terra: dal 10° al 5° (+5), con 51
- Gemini 4 Argon: dal 7° al 6° (+1), con 50
- Muse Wonder Full di Meta: dal 3° al 7° (-4), con 50
- Claude Fable 5.1: dal 5° all'8° (-3), con 49
- Kimi K3.1 Pro: dal 4° al 9° (-5), con 46
- Muse Wonder di Meta: dall'8° al 10° (-2), con 43
- Fuori dalla top 10 sale Claude Haiku 5.5, dal 18° all'11° posto (36), davanti a tutti i modelli open coi pesi già pubblicati
I primi cinque posti sono tutti di Anthropic e OpenAI. I punteggi della v5 non si confrontano uno a uno con quelli della v4.3, perché le prove sono diverse: quasi tutti i modelli perdono punti (in media circa 9 i chiusi e 13 gli open), mentre Opus 5.5, GPT-6 Astra e GPT-6.1 Sol ne guadagnano.
Open weights sempre più lontani
Nella v4.3 il miglior modello open era a 3 punti dal primo, ora è a 12. Il migliore resta Kimi K3.1 Pro (46), che però non ha ancora pubblicato i pesi. Fra quelli scaricabili oggi guidano DeepSeek V4.1 Flash 1017 e GLM-5.3, entrambi a 32: 26 punti sotto il primo e sotto anche Claude Haiku 5.5. Il distacco è più ampio su HLE-Diamond e Terminal-Bench-Science, dove Kimi fa 37% e 34% contro il 68% di Opus 5.5 e il 63% di GPT-6 Astra. Su Terminal-Bench-Science la maggior parte dei modelli open resta sotto il 10%.
Nessuno vince tutto
Delle nove prove, Opus 5.5 ne vince tre e le altre sei se le dividono cinque modelli diversi.
- Claude Opus 5.5: FrontierCode 2.0 (46%), HLE-Diamond (68%) e AA-Omniscience v1.1 (48)
- GPT-6 Astra: Terminal-Bench-Science (63%) e CritPt v2 (72%)
- Claude Sonnet 5.5: AA-Briefcase (1812 Elo)
- Kimi K3.1 Pro: Terminal-Bench 4.0 (67%)
- Gemini 4 Argon: AutomationBench-AA (78%)
- Muse Wonder Full: GDP.pdf (33% di documenti perfetti)
Su HLE-Diamond le domande di conoscenza restano le più dure: Opus 5.5 e GPT-6 Astra fanno entrambi 78% su quelle di ragionamento, ma solo 58% e 50% su quelle di conoscenza.
Costi e ragionamento
Fra i dieci modelli migliori il costo per task dell'indice cambia di oltre 13 volte: si va da 0,96 $ di GPT-6.1 Terra a 13,04 $ di Claude Fable 5.1. Opus 5.5 costa 10,04 $ a task, GPT-6 Astra 6,24 $ e GPT-6.1 Sol 1,27 $: Sol sta a 4 punti da Opus con circa un ottavo della spesa.
- Quanto il modello ragiona conta più di prima: Opus 5.5 fa 35 al livello più basso e 58 al massimo, a 10 volte il costo (0,98 $ contro 10,04 $)
- Per Sonnet 5.5 fra minimo e massimo ci sono 29 punti (erano 20), per GPT-6.1 Sol la distanza raddoppia da 10 a 20
- Le prove chiedono molto più lavoro: i token generati per task salgono per tutti, con la mediana da 35.000 a 59.000. Le prove agentiche valgono il 55% del peso ma consumano circa il 90% dei token, e Terminal-Bench-Science da solo ne prende un terzo
Arriva anche il Progress Index
Insieme alla v5 nasce il Progress Index v1, che mette su un'unica scala tutti i modelli usciti da novembre 2022 a oggi, così si può vedere quanto sono migliorati nel tempo anche fra modelli lontani anni. Per scegliere un modello oggi Artificial Analysis consiglia comunque l'Intelligence Index, che resta la misura principale.
Cosa significa
Con test che i modelli non possono aver visto, il vantaggio dei laboratori chiusi torna a essere netto, e la corsa al vertice è di nuovo fra Anthropic e OpenAI. Per chi sceglie un modello conta sempre di più anche il livello di ragionamento: lo stesso modello può valere 20 o 30 punti in più o in meno a seconda di quanto gli si lascia pensare, e il conto cambia di conseguenza.