Community
BabelArena: gli agenti AI messi alla prova in 23 lingue
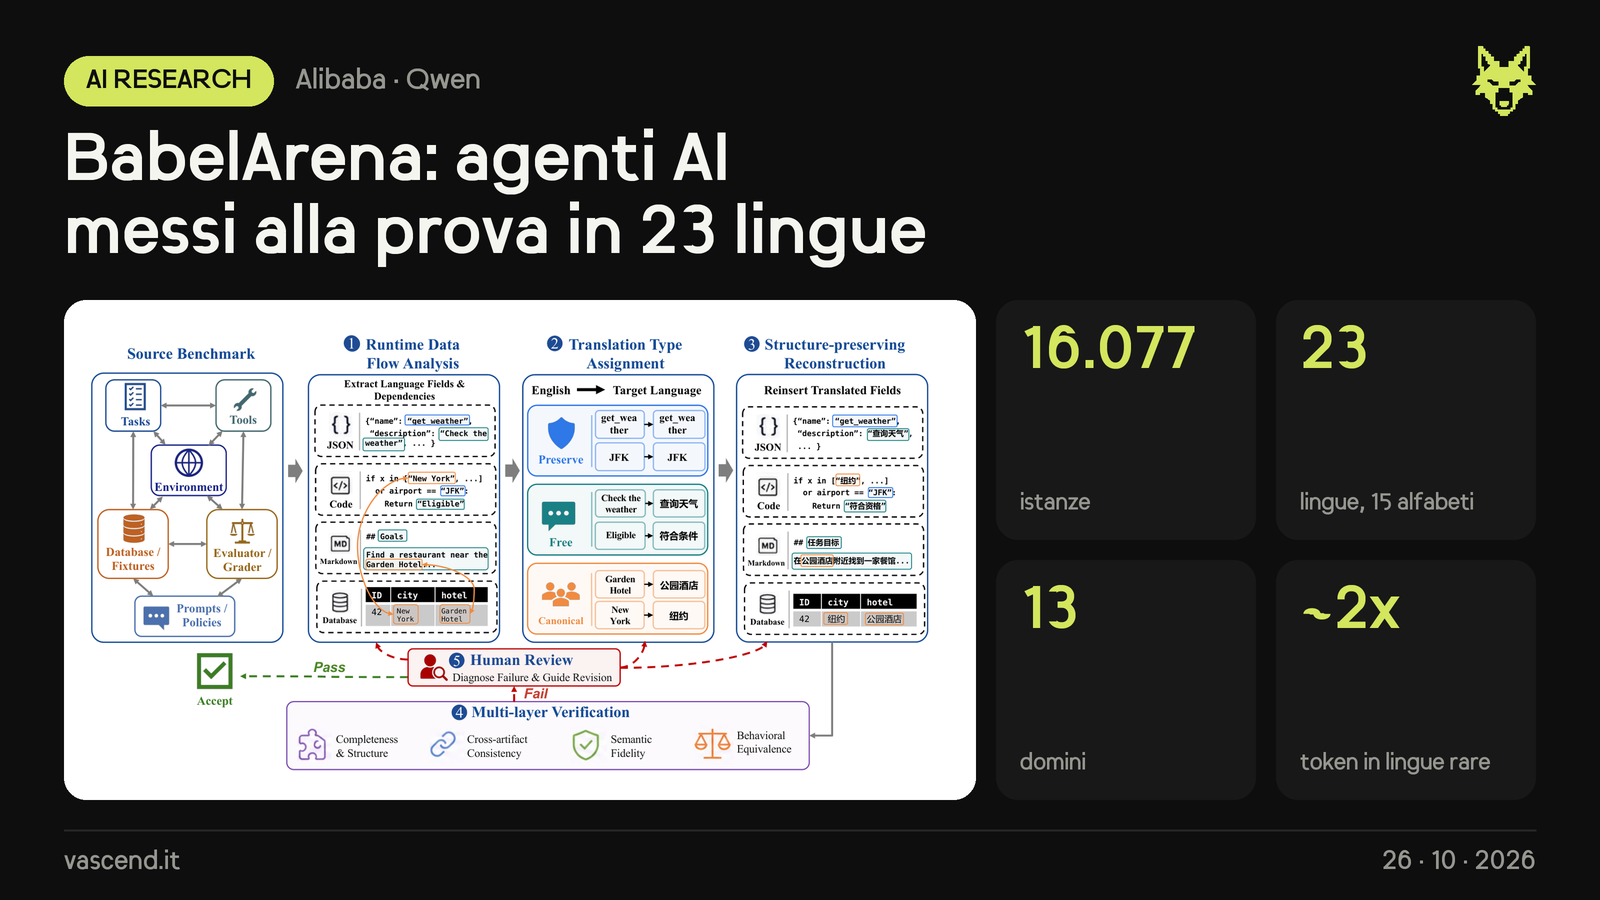
- BabelFlow porta in altre lingue i benchmark per agenti già esistenti senza rompere dipendenze, task e criteri di valutazione. Ne nasce BabelArena: 16.077 istanze da 699 task, 13 domini e 23 lingue (15 alfabeti, lingue molto, medio e poco diffuse)
- Testati cinque modelli di punta: Claude-Opus-4.8, GPT-5.6-Terra, Gemini-3.1-Pro, Qwen-3.7-Max e Qwen-3.8-Max. Nessuno vince ovunque
- Nelle lingue meno diffuse crescono gli errori nell'uso dei tool e nel flusso del task, i token in input arrivano a circa il doppio dell'inglese e le risposte tendono a scivolare in inglese
- Qwen-3.8-Max è primo su VitaBench (42,3% Pass^1) e DeepPlanning (46,0%). Dataset e codice sono open source (Apache 2.0)