Community
QwenGyre: reinforcement learning per agent che lavorano per ore
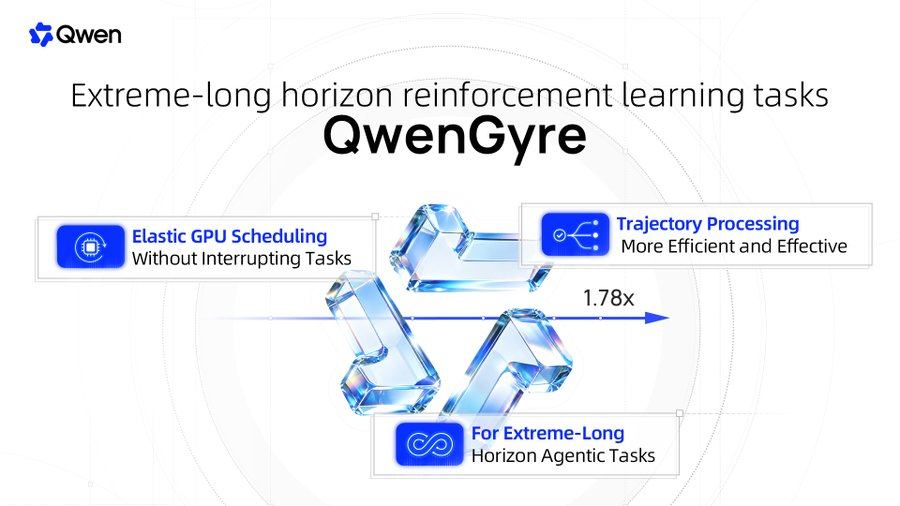
- Alibaba Qwen presenta QwenGyre, un framework di reinforcement learning online per agent su compiti lunghissimi: esecuzioni di ore, centinaia di interazioni e fino a quasi 1M token per tentativo.
- Scheduler elastico: sposta le GPU tra generazione e training senza fermare le esecuzioni in corso, così non restano ferme ad aspettare. Fino a 1,85× più veloce di Colocate e 1,78× di Async.
- Trajectory processor: ricostruisce i rami di un'esecuzione (compattazioni, sub-agent, nuovi tentativi), elimina i percorsi doppi e dà un punteggio anche al lavoro fatto a metà prima del timeout.
- Sul modello di punta Qwen 3.8 2.4T (700K token per tentativo): NL2RepoBench sale da 52,5% a 58,5% in 48 step, in circa il 44% di tempo in meno rispetto ad Async. Provato anche su DeepSWE e TerminalBench.