Vascend
HorizonVascend IDEVascend CLICommunityBenchmarkContact
Sign inJoin Discord
NewsVideosCoursesStackProjectsDiscord
Community

AI ToolsOct 26, 2026Article in Italian

Liquid RIPL, l'AI generativa dentro la singola richiesta
Liquid RIPL, l'AI generativa dentro la singola richiesta
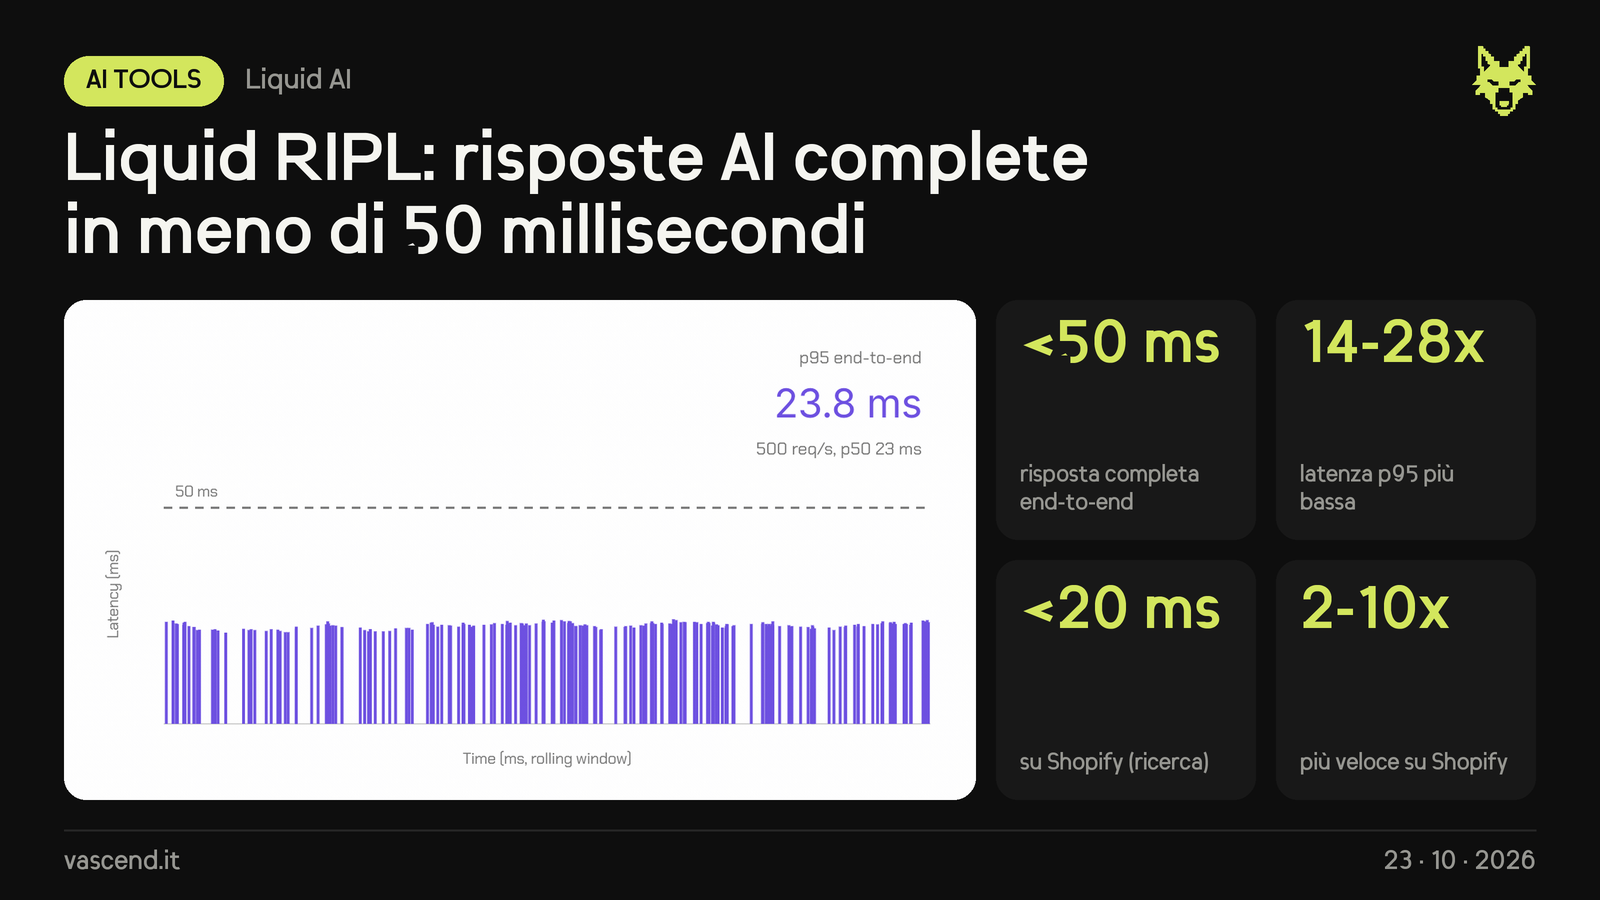
  • Liquid AI presenta RIPL (Real-time Inference Pipeline), un motore di inferenza a latenza bassissima per mettere i suoi modelli LFM direttamente nel percorso di una richiesta in tempo reale: ricerca, pubblicità, antifrode, raccomandazioni, pagamenti. Sono ambiti dove la risposta serve in millisecondi, non in secondi.
  • Restituisce risposte generate complete in meno di 50 ms, anche con traffico continuo al picco. Nei test di Liquid, LFM2.5-1.2B su RIPL ha una latenza p95 (il tempo entro cui arriva il 95% delle risposte) da 14.4 a 28.4 volte più bassa di Qwen3.5-0.8B su vLLM.
  • È già in produzione su Shopify per migliorare la ricerca: risposte sotto i 20 ms, modelli con circa la metà dei parametri delle alternative e inferenza da 2 a 10 volte più veloce, senza perdere qualità.
  • Disponibile per aziende su GPU NVIDIA come H100, H200, B200 e RTX PRO 6000.
Sources

  • Blog ufficiale
  • Thread X annuncio
  • Sito Liquid AI
NVIDIA

ShareWhatsAppTelegramXLinkedInFacebook

Discuss on Discord

Tell us what you think in #community-chat, with the other members.

  • #ai-newsthe news, as it breaks
  • #community-chattalk about anything
  • #help-n-questionsquestions and help
  • #your-productsmembers' projects
Join the Discord

14 online · 44 members

💡Suggest a story

More news

AI ToolsOct 26, 2026DeepInfer, DeepSeek apre il suo motore di inferenzaDeepSeek ha pubblicato il 20 ottobre DeepInfer, il framework di inferenza che usa internamente per far girare DeepSeek-V4.1-Flash su larga scala. È open source con licenza Apache 2.0 e ha già…AI ToolsOct 26, 2026Hostinger Agent diventa un unico agenteHostinger ha riprogettato Hostinger Agent: Kodee e gli agenti AI di Hostinger ora sono un solo agente, che sceglie da solo strumenti, skill e conoscenze per ogni richiestaAI ToolsOct 26, 2026EAGLE-4, lo speculative decoding che si adatta al caricoEagle rilascia EAGLE-4: un solo drafter addestrato per ogni modello adatta l'albero di speculative decoding a numero di richieste, hardware e carico, e l'output resta identico a quello del modello…
HorizonVascend IDEOlympusTalosCoursesCommunityBenchmark
DiscordGitHubXLet’s talkLegalPrivacyCookiesData useSecurity
© 2026 Vascend Technologies · VAT IT04911550616
ascend