Community
EAGLE-4, lo speculative decoding che si adatta al carico
- Eagle rilascia EAGLE-4: un solo drafter addestrato per ogni modello adatta l'albero di speculative decoding a numero di richieste, hardware e carico, e l'output resta identico a quello del modello originale.
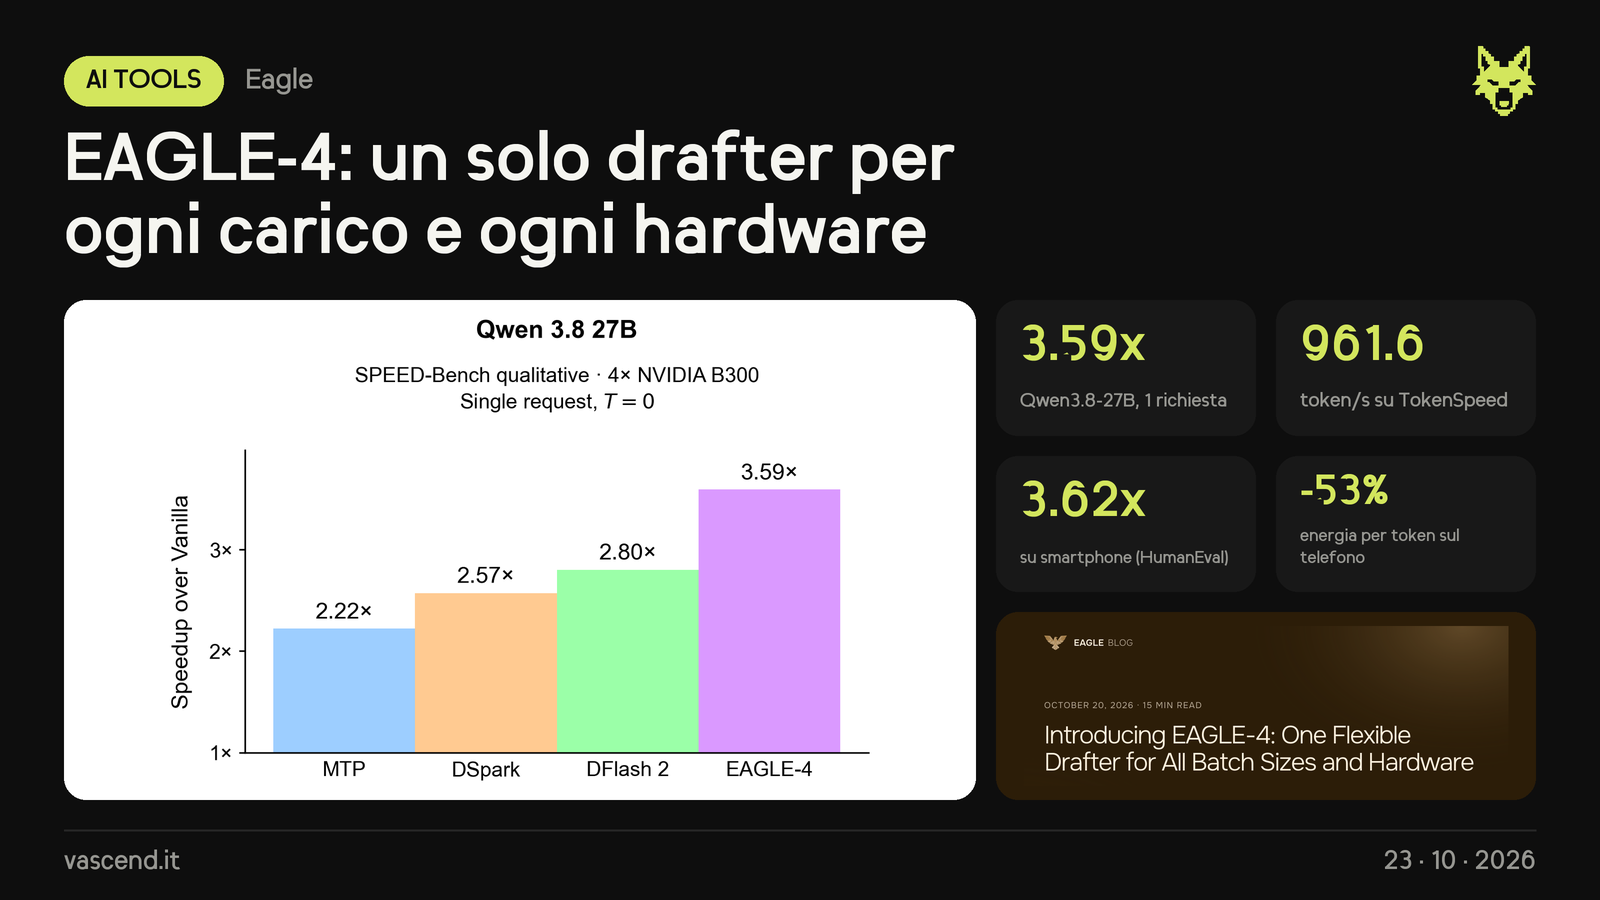
- Su Qwen3.8-27B (4× NVIDIA B300, TP4, T=0) arriva a 863.8 token/s con una richiesta, 3.59x il decoding normale (240.5), e a 28.340 token/s aggregati con 512 richieste (1.34x), davanti a DFlash 2 e DSpark. Su TokenSpeed tocca 961.6 token/s. Su Nemotron 3.5 Super VL fa 2.74x con una richiesta e 1.69x a 512; su una AMD MI350X 3.49x.
- Funziona anche su CPU e su uno smartphone senza root: con Gemma-4-E2B a 4 bit 3.62x su HumanEval e -53% di energia per token. EAGLE-Harness misura i costi e sceglie profondità e larghezza dell'albero; l'Efficient LM Head taglia fino al 55% la latenza di ogni passo del drafter.
- Si integra con SGLang, vLLM e TokenSpeed; pesi del drafter su Hugging Face. Il codice è pubblico ma con licenza "source available", non open source.