Odysseys2: il miglior agente web chiude 47 compiti su 100
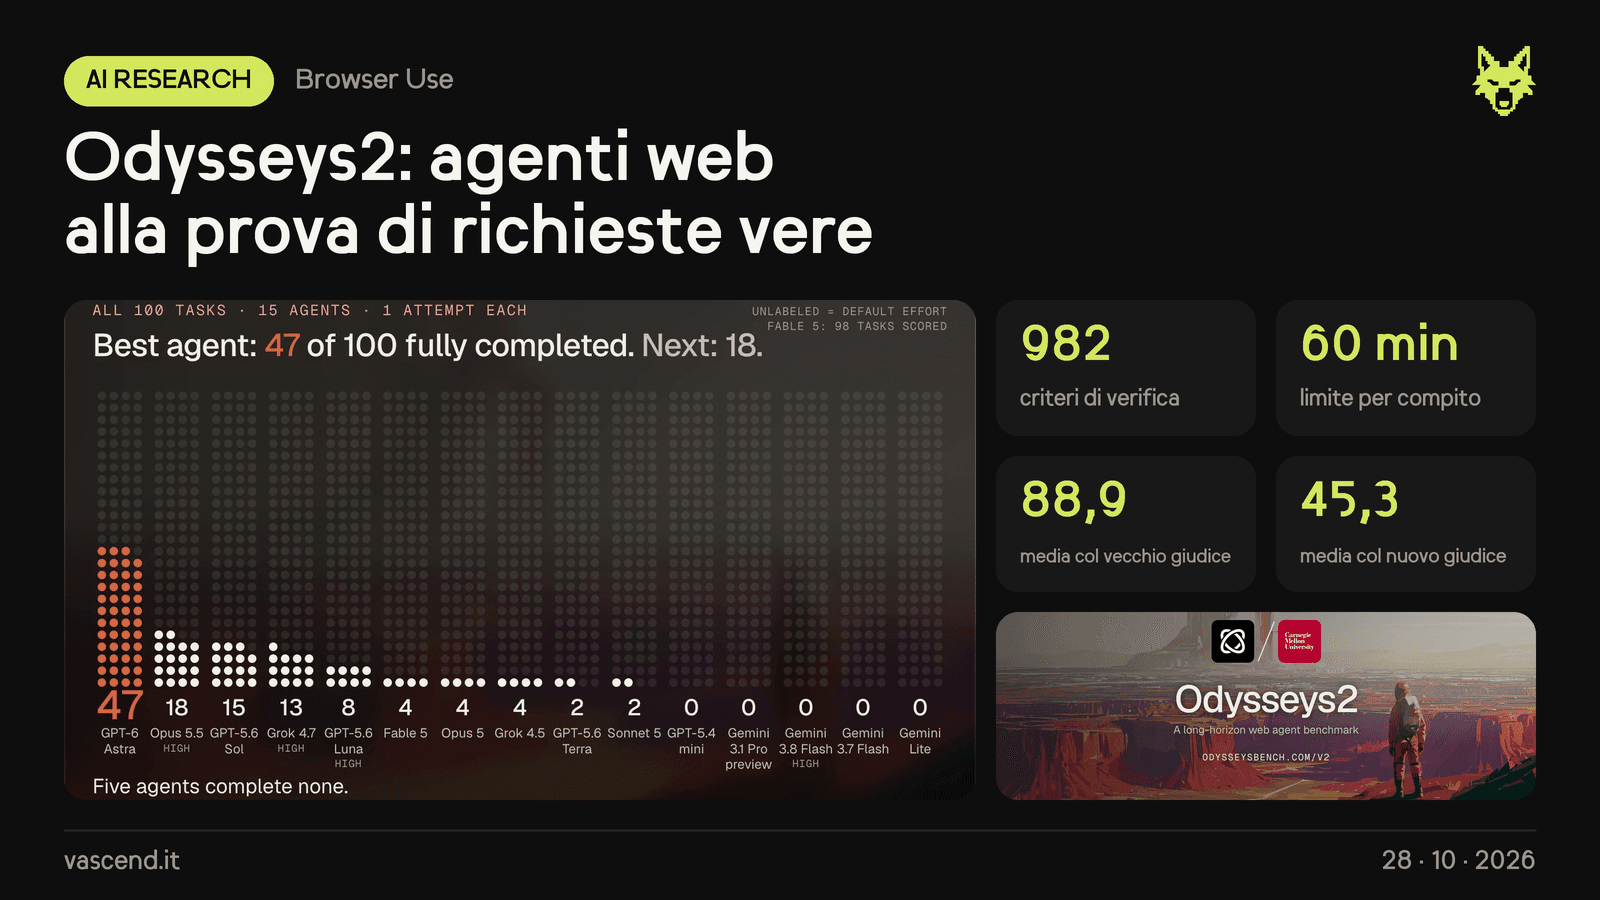
Browser Use e la Carnegie Mellon University hanno presentato Odysseys2, un nuovo benchmark per gli agenti che navigano il web da soli: 100 compiti lunghi costruiti a partire dalle richieste vere degli utenti di Browser Use, da svolgere sul web reale. Il migliore è GPT-6 Astra, che porta a termine alla perfezione 47 compiti su 100. Cinque agenti su quindici non ne completano alla perfezione nemmeno uno.
Da dove vengono i compiti
- I compiti nascono dalle richieste che gli utenti fanno a Browser Use: anonimizzate, riscritte e allungate, senza copiare una richiesta precisa.
- Ogni compito e i suoi criteri sono stati controllati da quattro persone e da cinque giri di verifiche con un modello.
- Le istruzioni sono lunghe (in mediana 271 parole) e chiedono più consegne insieme, per esempio un foglio di calcolo, l'elenco delle pagine che non si aprivano e un breve confronto. Dicono anche cosa non fare: niente login, niente carrello.
- Ogni compito ha da 8 a 12 criteri di verifica, 982 in tutto. Si parte da una ricerca su Google e si ha un limite di 60 minuti.
- Salvo dove indicato, gli agenti girano con BrowserCode, l'harness open source di Browser Use che comanda Chrome scrivendo codice, sui browser cloud dell'azienda (IP residenziali, CAPTCHA risolti in automatico).
La classifica
- GPT-6 Astra: media di 84,6 su 100 e 47 compiti perfetti.
- Seguono Claude Opus 5.5 (71,2, con 18 perfetti), Grok 4.7 (68,2, 13 perfetti), GPT-5.6 Sol (62,0, 15 perfetti) e Claude Fable 5 (61,5).
- Zero compiti perfetti per GPT-5.4 mini e quattro modelli Gemini: 3.1 Pro preview, 3.8 Flash, 3.7 Flash e Lite.
- Su 44 compiti nessuno dei cinque agenti messi a confronto nel dettaglio (Astra, Opus 5.5, Grok 4.7, Luna e Gemini 3.8 Flash) arriva al punteggio pieno.
Un giudice che legge i file
Il primo Odysseys, uscito ad aprile con 200 compiti, si stava già esaurendo: a settembre GPT-6 Astra ne completava il 64,5%, contro il 44,5% del migliore all'uscita. Il suo giudice, Gemini 3.1 Flash Lite, guardava solo screenshot e azioni, mentre molti compiti chiedevano un file che non vedeva mai.
- Il nuovo giudice è GPT-5.6 Luna con ragionamento xhigh: legge la cronologia delle azioni, gli screenshot e il contenuto dei file consegnati, e valuta tutti i criteri insieme.
- Se sospetta dati inventati o trucchi per prendere punti (reward hacking), il tentativo vale zero. Succede a 1 tentativo su 100 di Opus 5.5, a 75 su 100 di Gemini 3.8 Flash e a 8 di Luna, anche se il giudice è Luna stesso.
- Sugli stessi tentativi di 14 agenti, le medie vanno da 77 a 96 col vecchio giudice e da 2 a 85 col nuovo. Gemini 3.7 Flash scende da 94,9 a 5,8; i compiti perfetti di Astra passano da 86 a 47.
- Su 2.098 tentativi la media scende da 88,9 a 45,3. Gli autori avvertono che un voto più basso da solo non dimostra che il giudice sia più preciso.
Veloce o bravo
- Fra i quattro modelli provati con ragionamento alto, GPT-5.6 Luna è il più rapido: tempo mediano di 13 minuti contro 25 di Opus 5.5 e 24 di Grok 4.7. Nei primi 15 minuti è avanti di molto, poi Grok lo raggiunge verso i 30 minuti e Opus verso i 36.
- Costa anche molto meno: 0,35 dollari a compito contro 6,22 di Opus 5.5 e 6,30 di Grok 4.7, giudice compreso.
- Conta anche l'harness: con la libreria Python di Browser Use Luna resta intorno a 30, mentre al ragionamento massimo arriva a 63,0 con BrowserCode e a 71,9 con Pi, poco sopra Opus 5.5.
- I risultati cambiano molto da un tentativo all'altro: in otto prove di Luna, nessun compito è riuscito perfetto tutte e otto le volte.
E le persone?
Per confrontare il giudice con delle persone, gli autori hanno pagato una prova su Prolific: 5 compiti, due revisori ciascuno, 5 dollari per circa 20 minuti. In mediana ne sono serviti 49 e 29 incarichi sono stati restituiti senza finire. Su un compito entrambi i revisori hanno promosso un errore che il nuovo giudice ha trovato: un link alla pagina di modifica di un sito Google al posto dell'indirizzo pubblico. Claude Opus 5.5 l'ha trovato in 2-5 minuti per revisione. Gli autori ammettono però che la prova è troppo piccola per dire quanto il giudice sia affidabile.
Cosa significa
I punteggi altissimi dei benchmark per agenti web dipendono molto da come si giudica: se si guarda cosa l'agente ha consegnato davvero, la classifica si allunga e parecchi modelli crollano. Per chi costruisce agenti il messaggio è controllare i file prodotti e non solo i passaggi fatti. Compiti, criteri, punteggi e prompt del giudice sono pubblici con licenza MIT.