Community
STAIR, il retriever di IBM che cerca nell'indice
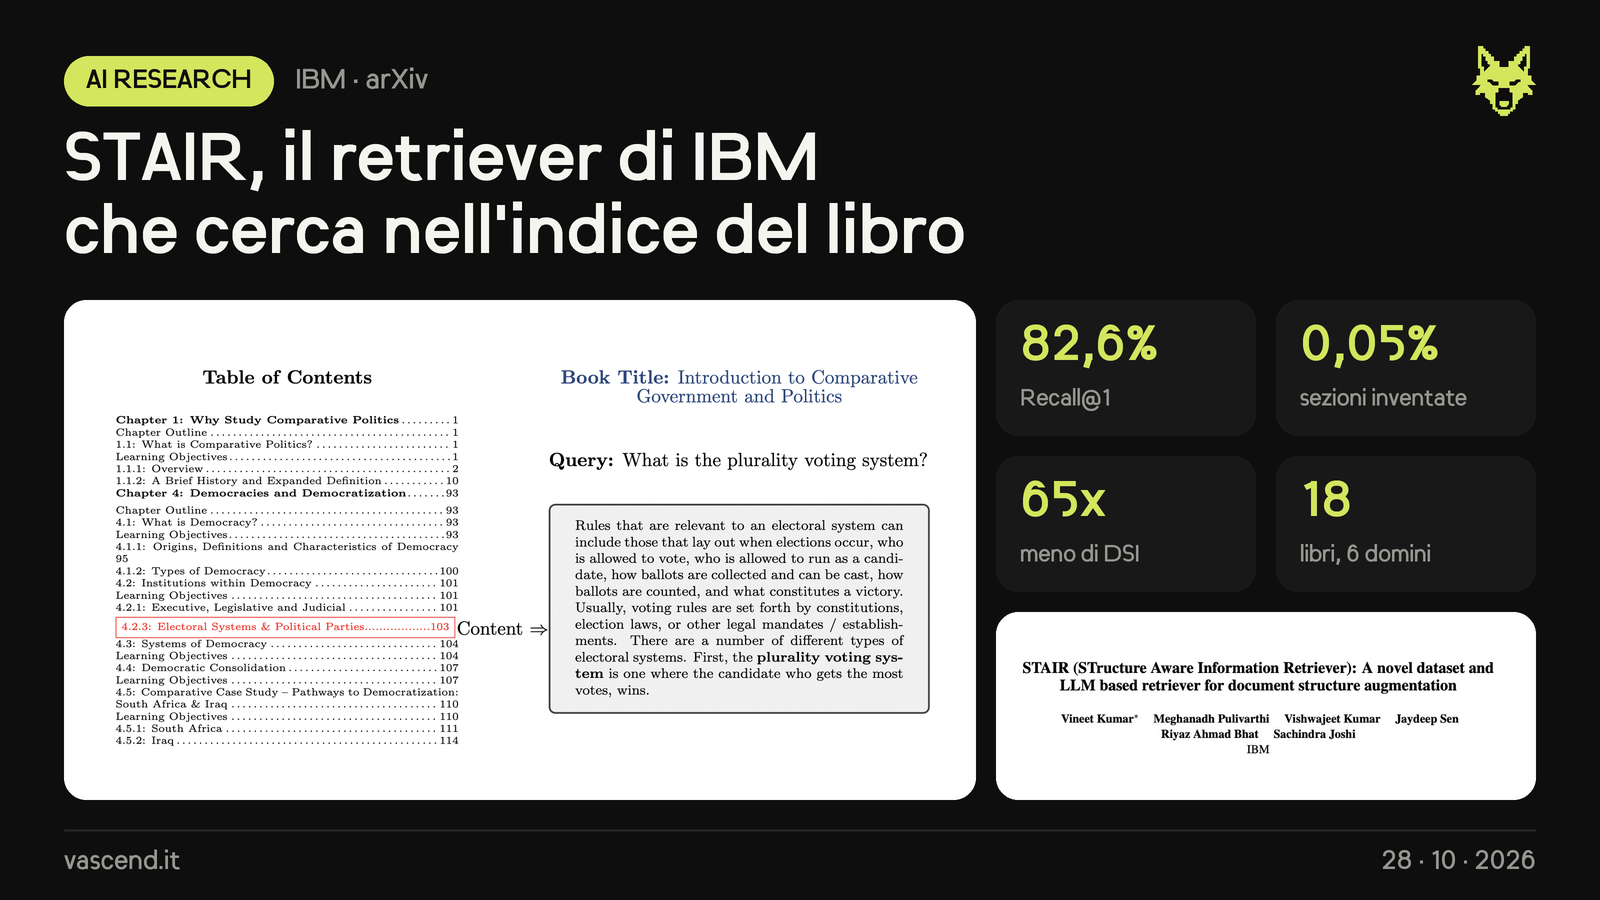
- Un gruppo di ricercatori IBM presenta STAIR (STructure Aware Information Retriever): invece di spezzare i documenti in chunk di lunghezza fissa, usa l'indice del libro come mappa per trovare la sezione che risponde alla domanda
- Il modello è Mistral 7B Instruct v0.2 affinato con LoRA: riceve la domanda insieme all'indice completo e scrive il titolo della sottosezione giusta, dopo aver imparato i contenuti del corpus in addestramento
- Sul nuovo benchmark SearchTome (18 libri di testo aperti in 6 domini, dalla finanza alla medicina) arriva all'82,6% di Recall@1, contro il 76,9% di DSI, il 68,7% di un retriever a embedding (NV-Embed-v2), il 59,5% di BM25 e il 45,6% di Claude Haiku 4.5
- Qui "allucinazione" vuol dire indicare una sezione che non esiste (o non valida) nell'indice: succede nello 0,05% dei casi con STAIR e nel 3,25% con DSI. Da qui il 65x che gira sui social, che quindi non misura le risposte inventate di un sistema RAG completo
- Il distacco è più ampio sulle sezioni con pochi esempi di addestramento, dove DSI sbaglia e inventa di più
- Limiti: il modello va addestrato sul corpus, le domande del benchmark sono sintetiche (generate con Mixtral 8x7B) e i test sono solo su libri. Codice e dataset sono pubblici