Community
ScaleDown lancia i CDM: come i decision model, ma fanno di più
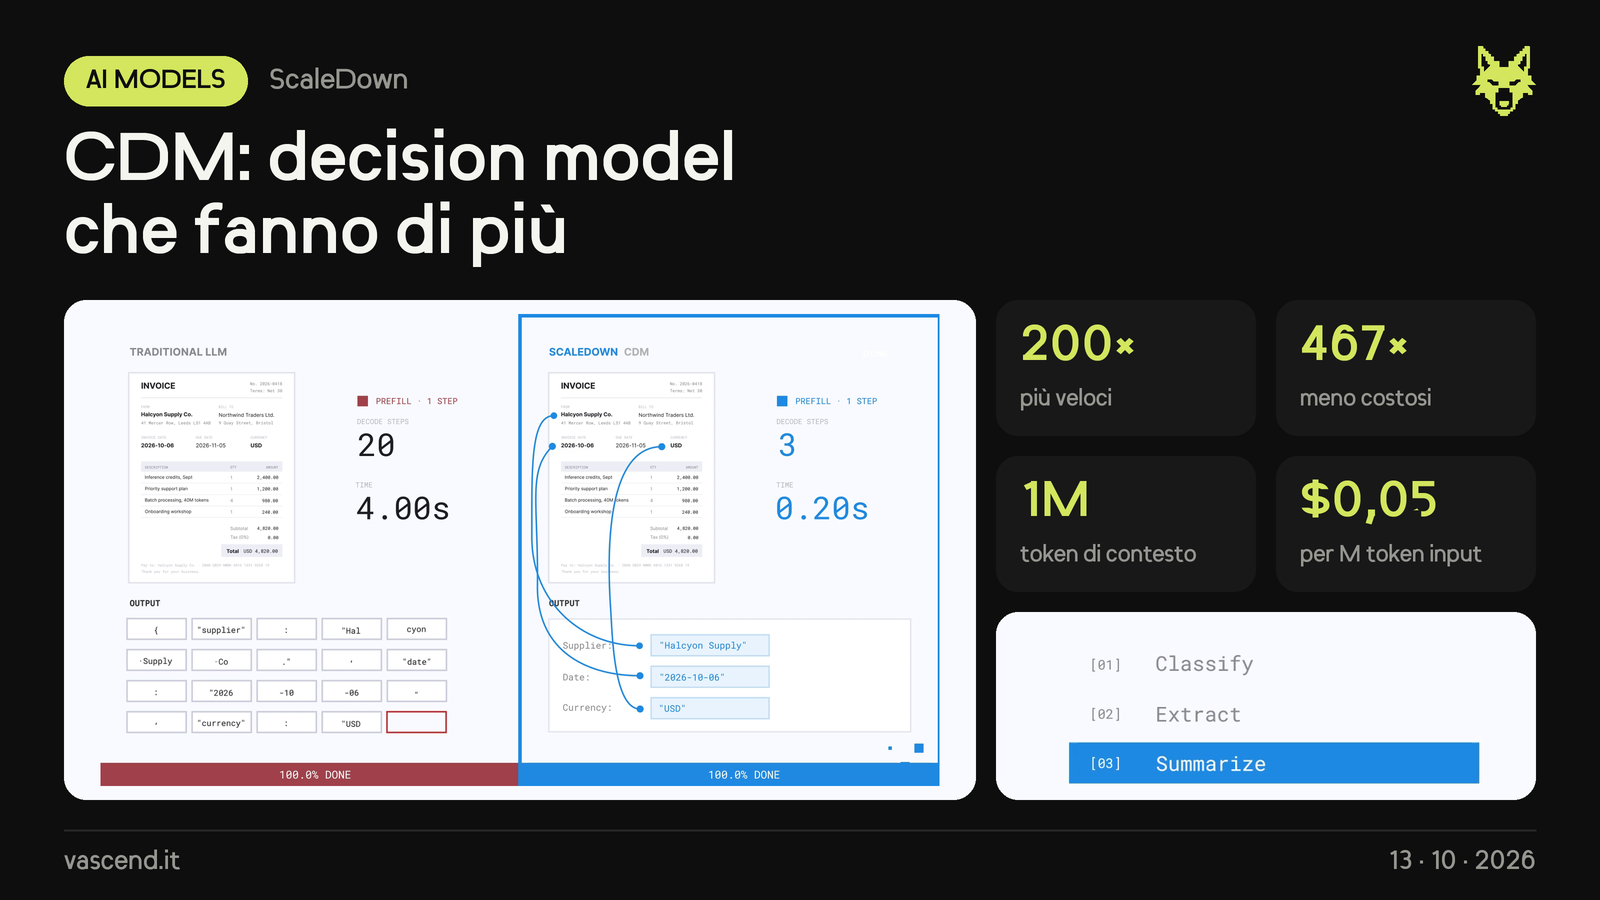
- ScaleDown ha presentato i CDM (Constrained Decoding Models): ogni modello fa un solo compito, legge l'input una volta e salta la generazione token per token che rende gli LLM lenti e costosi
- Come i decision model stile Jev danno risposte strutturate invece di testo libero, ma non si fermano alla decisione. Per ora sono tre:
- Classify: etichette scelte da te, con probabilità e motivazione (smistamento, tag, moderazione)
- Extract: descrivi a parole i campi e torna un JSON con confidenza e citazioni, anche da foto, scansioni e PDF
- Summarize: testi lunghi, immagini o PDF diventano un riassunto sotto i 1.000 token
- Accanto c'è Compress, che taglia il contesto del 50-70% prima della chiamata all'LLM
- La Decisions API è compatibile con Jev (
choice,noul,score): basta cambiare l'URL e in più legge documenti e immagini - I numeri: 1M token di input multimodale (31× Jev), 77,2% su DecisionBench contro il 72% di Jev, $0,05 per milione di token in input e output gratis
- Benchmark dichiarati, contro la media di ogni fornitore: su Anthropic +8% di accuratezza, 3,8× più veloci e 161× meno costosi; su OpenAI +8,7%, 2,4× e 89×; su Gemini +9% e 8,3×
- Per chi programma: DietCode riduce i token di Claude Code, Codex CLI e Cursor, mentre ScaleDown Agent (MCP) trova nel codice le chiamate agli LLM da passare ai CDM
- Già disponibili su OpenRouter, Vercel, LiteLLM e LangChain