Vascend
HorizonVascend IDEVascend CLICommunityBenchmarkContatti
AccediEntra su Discord
NotizieVideoCorsiStackProgettiDiscord
Community

AI Tools27 ott 2026

Cohere Rerank 5: ricerca più precisa e meno token per RAG e agenti
Cohere Rerank 5: ricerca più precisa e meno token per RAG e agenti
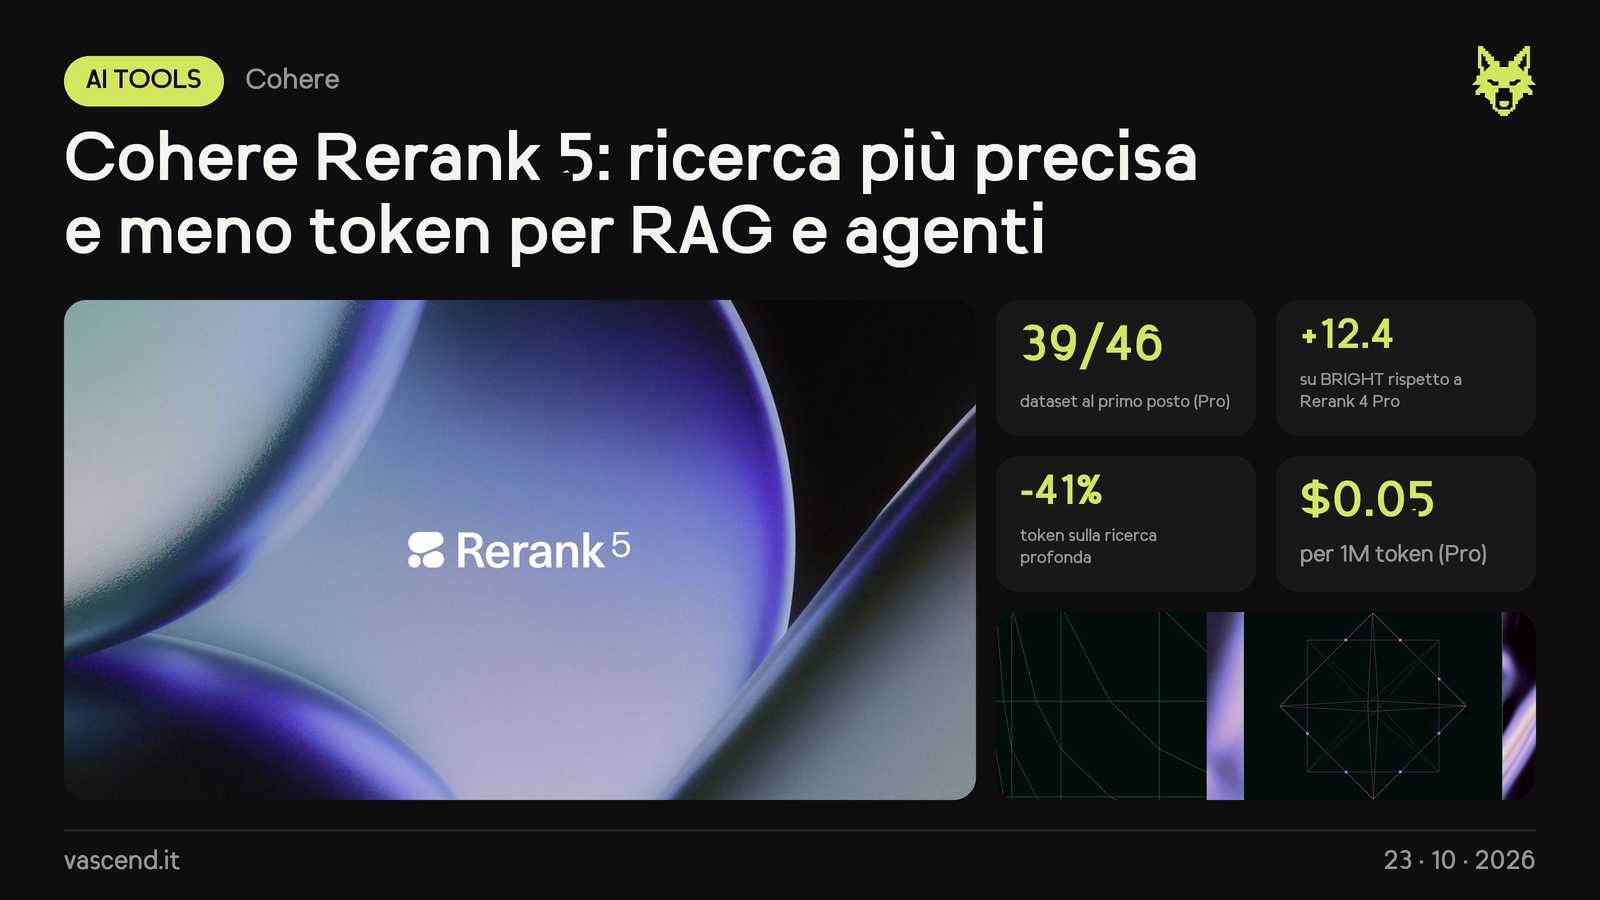
  • Cohere lancia Rerank 5, un modello di reranking: dopo una prima ricerca, rimette in ordine i documenti trovati e porta in cima quelli davvero utili, così l'LLM legge meno testo e risponde meglio. Due versioni: Pro (~2B parametri) e Fast (~500M), con contesto di 32k token.
  • Pro è primo su ViDoRe V3, nanoMTEB, BRIGHT e BEIR: primo in 39 dataset su 46. Su BRIGHT, che premia il ragionamento, fa +12.4 punti su Rerank 4 Pro e +5.8 su Voyage AI Rerank 3. Va forte su finanza, sanità e ricerca scientifica e migliora in tutte le 19 lingue non inglesi testate. Fast su una GPU A100 riordina circa 187 documenti al secondo, 2.9x Pro, risponde quasi 3x più in fretta e batte comunque Voyage Rerank 3 Lite e Qwen3-Reranker-8B.
  • Novità Context Focus (opzionale): invece del documento intero restituisce i passaggi più rilevanti, ognuno col suo punteggio. In un agente di ricerca, sui sei benchmark di ricerca profonda, ha usato il 41% di token in meno con più risposte giuste (dal 39% al 52%). I punteggi ora sono calibrati: 0.7 vuol dire 70% di probabilità che il documento serva.
  • Costa $0.05 per 1M token (Pro) e $0.02 (Fast). Disponibile su Cohere API, Model Vault, Microsoft Foundry, Amazon SageMaker, North e anche sui propri server.
Fonti

  • Blog ufficiale
  • Docs Rerank
  • Changelog
  • Thread X
AgentiMicrosoftAmazon

CondividiWhatsAppTelegramXLinkedInFacebook

Commenta su Discord

Dicci cosa ne pensi in #community-chat, insieme agli altri membri.

  • #ai-newsle notizie, appena escono
  • #community-chatsi parla di tutto
  • #help-n-questionsdomande e aiuto
  • #your-productsi progetti dei membri
Entra nel Discord

7 online · 44 membri

💡Suggerisci una notizia

Altre notizie

AI Tools26 ott 2026Liquid RIPL, l'AI generativa dentro la singola richiestaLiquid AI presenta RIPL (Real-time Inference Pipeline), un motore di inferenza a latenza bassissima per mettere i suoi modelli LFM direttamente nel percorso di una richiesta in tempo reale:…AI Tools26 ott 2026DeepInfer, DeepSeek apre il suo motore di inferenzaDeepSeek ha pubblicato il 20 ottobre DeepInfer, il framework di inferenza che usa internamente per far girare DeepSeek-V4.1-Flash su larga scala. È open source con licenza Apache 2.0 e ha già…AI Tools26 ott 2026Hostinger Agent diventa un unico agenteHostinger ha riprogettato Hostinger Agent: Kodee e gli agenti AI di Hostinger ora sono un solo agente, che sceglie da solo strumenti, skill e conoscenze per ogni richiesta
HorizonVascend IDEOlympusTalosCorsiCommunityBenchmark
DiscordGitHubXParliamoneNote legaliPrivacyCookieUso dei datiSicurezza
© 2026 Vascend Technologies · VAT IT04911550616
ascend