Vascend
HorizonVascend IDEVascend CLICommunityBenchmarkContatti
AccediEntra su Discord
NotizieVideoCorsiStackProgettiDiscord
Community

AI Tools26 ott 2026

DeepInfer, DeepSeek apre il suo motore di inferenza
DeepInfer, DeepSeek apre il suo motore di inferenza
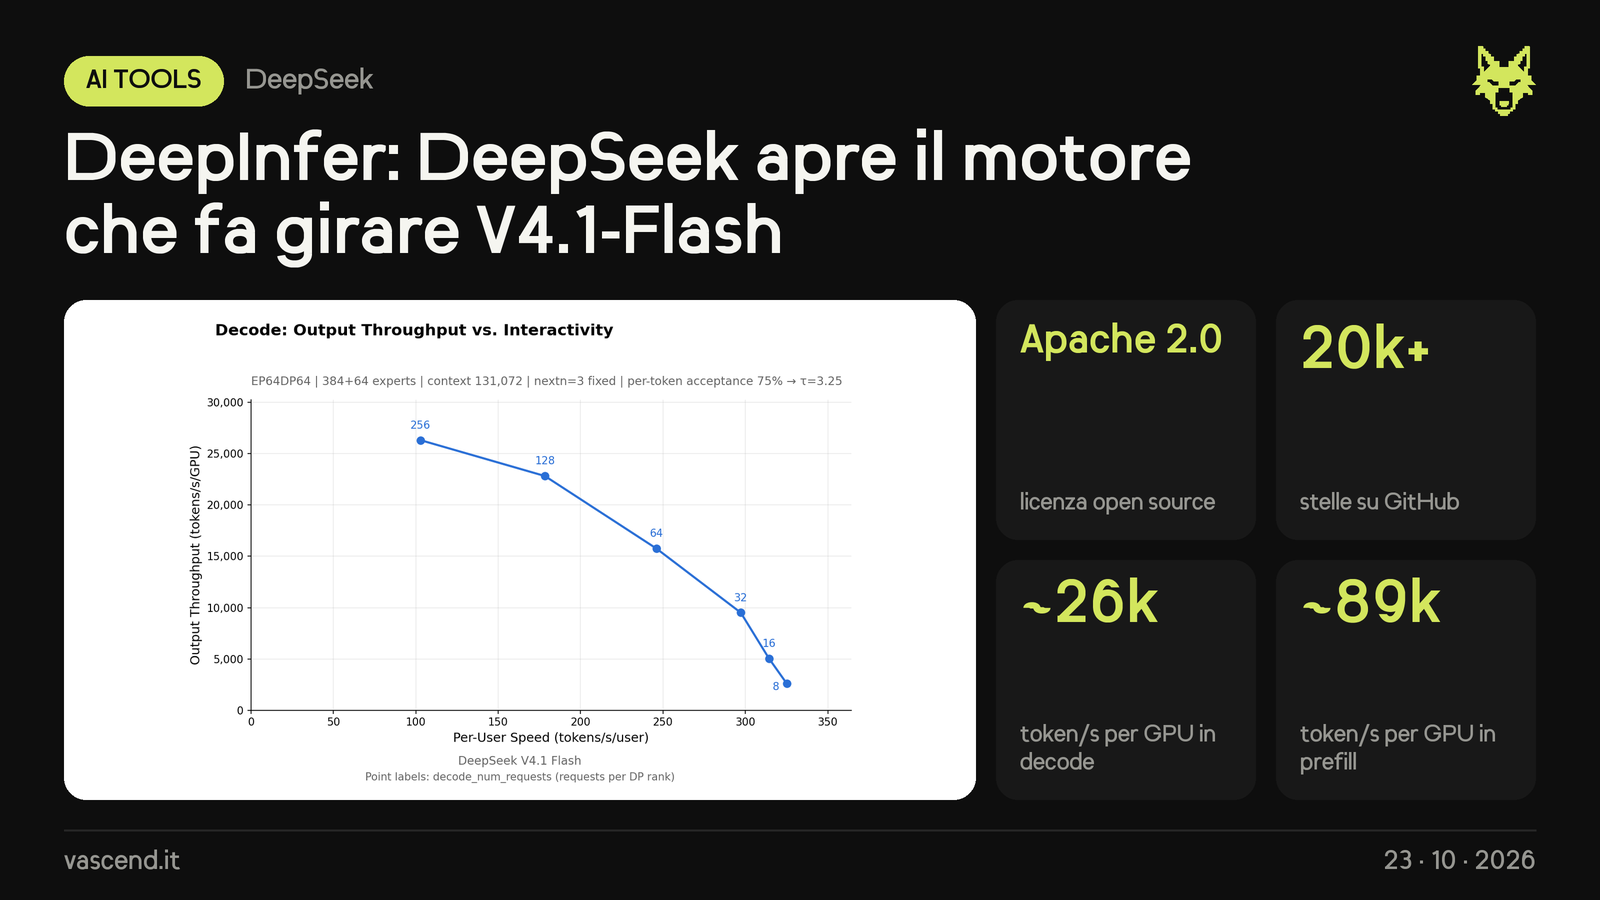
  • DeepSeek ha pubblicato il 20 ottobre DeepInfer, il framework di inferenza che usa internamente per far girare DeepSeek-V4.1-Flash su larga scala. È open source con licenza Apache 2.0 e ha già superato le 20.000 stelle su GitHub.
  • Dentro ci sono i kernel ottimizzati di casa (FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect), il parallelismo (Attention DP, CP bilanciato, MoE EP+EPLB), DSpark con verifica programmata in base alla confidenza, lo SWA bounded replay, lo scheduling asincrono, l'inferenza indipendente dal batch e gli output strutturati (regex, JSON Schema, EBNF). Gira su GPU NVIDIA SM100 e NPU Huawei Ascend 950.
  • Questa versione copre l'inferenza offline: per un servizio completo mancano ancora il sistema di KV cache, la separazione prefill/decode e il bilanciamento fra repliche. Nei benchmark ufficiali su V4.1-Flash tocca circa 89.000 token/s per GPU in prefill e 26.000 in decode.
  • Accanto c'è deepseek-recipe (licenza MIT): librerie Rust con binding Python che convertono le richieste nei formati Messages, Chat Completions e Responses, le trasformano in prompt per i modelli DeepSeek e ne rileggono l'output, così da collegare un backend di inferenza alle API. DeepInfer nasce da vLLM, con spunti da SGLang e TensorRT-LLM.
Fonti

  • GitHub DeepInfer
  • GitHub deepseek-recipe
  • Modello su Hugging Face
  • Annuncio X
DeepSeekNVIDIAHugging FaceOpen source

CondividiWhatsAppTelegramXLinkedInFacebook

Commenta su Discord

Dicci cosa ne pensi in #community-chat, insieme agli altri membri.

  • #ai-newsle notizie, appena escono
  • #community-chatsi parla di tutto
  • #help-n-questionsdomande e aiuto
  • #your-productsi progetti dei membri
Entra nel Discord

10 online · 44 membri

💡Suggerisci una notizia

Altre notizie

AI Tools26 ott 2026Hostinger Agent diventa un unico agenteHostinger ha riprogettato Hostinger Agent: Kodee e gli agenti AI di Hostinger ora sono un solo agente, che sceglie da solo strumenti, skill e conoscenze per ogni richiestaAI Tools26 ott 2026EAGLE-4, lo speculative decoding che si adatta al caricoEagle rilascia EAGLE-4: un solo drafter addestrato per ogni modello adatta l'albero di speculative decoding a numero di richieste, hardware e carico, e l'output resta identico a quello del modello…AI Tools25 ott 2026La Decisions API di OpenAI esce dalla betaLa Decisions API di OpenAI, lanciata in beta il 6 ottobre, dal 22 ottobre è disponibile per tutti. Su gpt-6-luna trasforma testo, immagini e JSON in risposte tipizzate circa 10x più velocemente…
HorizonVascend IDEOlympusTalosCorsiCommunityBenchmark
DiscordGitHubXParliamoneNote legaliPrivacyCookieUso dei datiSicurezza
© 2026 Vascend Technologies · VAT IT04911550616
ascend