Community
LFM2.5-24B-A2B: reasoning MoE per agent in locale
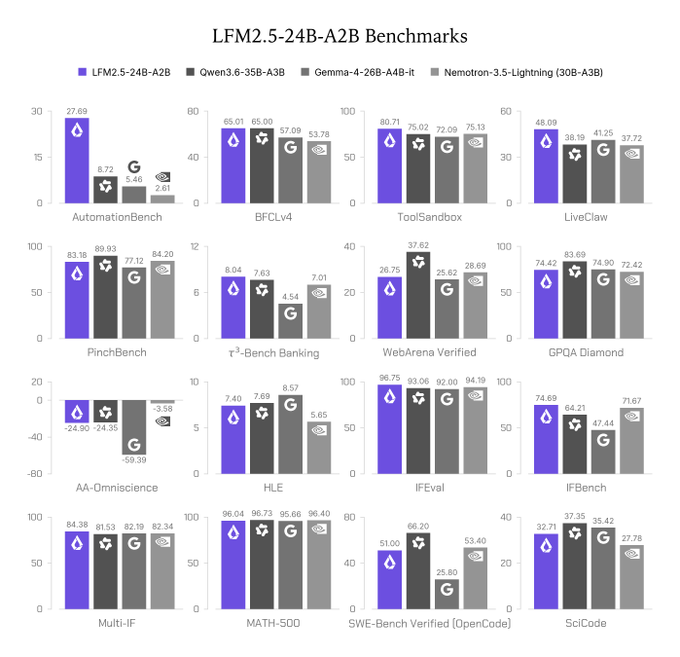
- Liquid AI rilascia LFM2.5-24B-A2B, il più grande della famiglia LFM2.5: 24B parametri totali ma solo 2B attivi per token, contesto da 131K e vocabolario da 128K.
- È un modello di ragionamento (chain of thought esplicita) pre-addestrato su 33T token. Se la gioca con Qwen3.6-35B-A3B, che ha circa il 50% di parametri in più, su task agentici e uso di tool: 48,09 su LiveClaw e 27,69 su AutomationBench.
- Fino a 1,7× più veloce sul dispositivo: 184 token/s su Apple M5 Max e oltre 21k token/s in output su NVIDIA B300. Supporto dal primo giorno per llama.cpp, MLX, vLLM, SGLang e ONNX.
- Pesi aperti (base e post-trained) e fine-tunabile: ideale per agent multi-step su laptop e PC.