Particle-1, il modello che spreca meno token
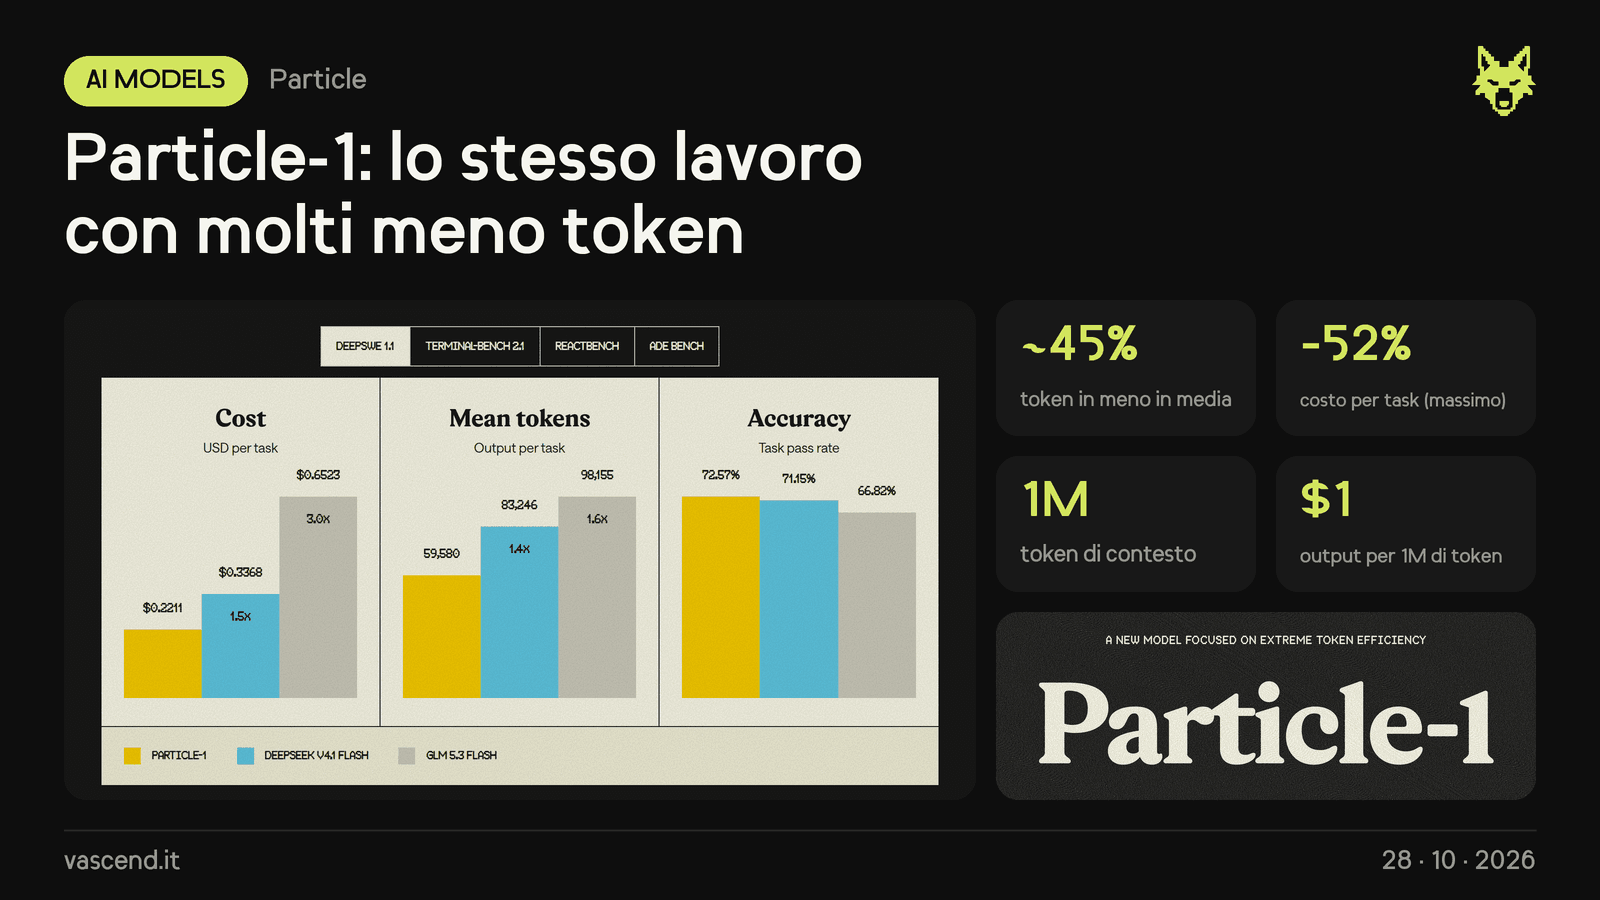
Suhail Doshi, fondatore di Mixpanel e di Playground AI, ha lanciato una nuova azienda, Particle, e il suo primo modello: Particle-1. È pensato per gli sviluppatori e addestrato a risolvere compiti di programmazione usando meno token: secondo Particle ne usa in media circa il 45% in meno rispetto al modello di partenza, DeepSeek V4.1 Flash, con una precisione paragonabile. È già disponibile tramite l'API di Particle.
Come è stato addestrato
- Particle-1 non parte da zero: è un post-training di DeepSeek V4.1 Flash fatto con il reinforcement learning.
- La ricompensa premia il modello quando risolve il compito usando meno token per ragionare e per chiamare gli strumenti.
- Gli ambienti di addestramento sono compiti di coding e data engineering, generati da un sistema interno di dati sintetici chiamato Datamaker.
- L'addestramento è diviso in due fasi: prima solo coding, poi soprattutto data engineering. Già dopo la prima fase il modello usava circa il 20% di token in meno anche sui compiti di data engineering, su cui non era ancora stato addestrato.
- Viene addestrato solo un adattatore LoRA: i parametri modificati sono circa l'1,25% di quelli del modello.
I risultati sui benchmark
Particle ha provato il modello su quattro benchmark di agenti: DeepSWE 1.1, Terminal-Bench 2.1, ReactBench e ADE Bench. Rispetto a DeepSeek V4.1 Flash:
- usa dal 28,4% al 52,2% di token di output in meno;
- il costo medio per compito scende dal 34,4% al 51,6%;
- la quota di compiti risolti resta vicina: un po' più alta su DeepSWE (72,6% contro 71,2%), da 1,9 a 3,5 punti più bassa sugli altri tre, ma dentro gli intervalli di confidenza secondo Particle;
- sui benchmark generali cambia poco: GPQA Diamond 90,4% (base 90,9%), MMLU 86,1% (base 86,0%).
Da dove arriva il risparmio
Confrontando le esecuzioni riuscite dei due modelli sugli stessi compiti, Particle ha trovato quattro differenze:
- meno ragionamento per fare le stesse azioni;
- si ferma appena il compito è finito, senza ricontrollare e riconfermare tutto;
- meno giri di tentativi e correzioni prima di arrivare a una soluzione funzionante;
- esplorazione e verifiche più mirate.
Su Terminal-Bench, ReactBench e ADE Bench circa il 90% del risparmio viene dal ragionamento. In un compito di deploy con Git le ultime due conferme passano da 11.445 a 1.765 token.
Oltre il codice
Ci sono i primi segnali che il comportamento si trasferisca anche ad altri ambiti. In un compito legale di Harvey LAB (controllare una clausola arbitrale su quattro documenti e scrivere un report in Word) Particle-1 ha usato il 24,6% di token in meno e tutti gli 8 report hanno superato ogni criterio, contro il 62,5% di DeepSeek V4.1 Flash. È però una prova su un solo compito.
Prezzi e disponibilità
- Si usa con l'API di Particle, compatibile con gli SDK di OpenAI.
- Contesto da 1.048.576 token, input di testo e immagini, ragionamento regolabile e chiamata di strumenti.
- Prezzo: 0,25 $ per milione di token in input, 0,03 $ in cache e 1,00 $ in output, lo stesso di DeepSeek V4.1 Flash sulla stessa piattaforma: il risparmio arriva tutto dai token in meno.
- Nella fascia off-peak (dalle 20:30 alle 04:00, ora di New York) i prezzi scendono del 50%.
- Zero data retention: prompt e risposte vengono elaborati in memoria e non vengono salvati.
- Sulla piattaforma ci sono anche DeepSeek V4.1 Flash e GLM 5.3 Flash.
Cosa significa
Il primo obiettivo di Particle è abbassare il costo dell'intelligenza per gli sviluppatori. Meno token vuol dire costi più bassi e compiti finiti prima. Particle-1 è il primo di una serie di modelli per sviluppatori: Suhail scrive che il traguardo è il post-training continuo, cioè migliorare i modelli con la stessa frequenza con cui si rilascia software. L'azienda ha sede a San Francisco ed è sostenuta da Y Combinator, Caffeinated Capital e 8VC.