Mistral apre la Responses API in anteprima
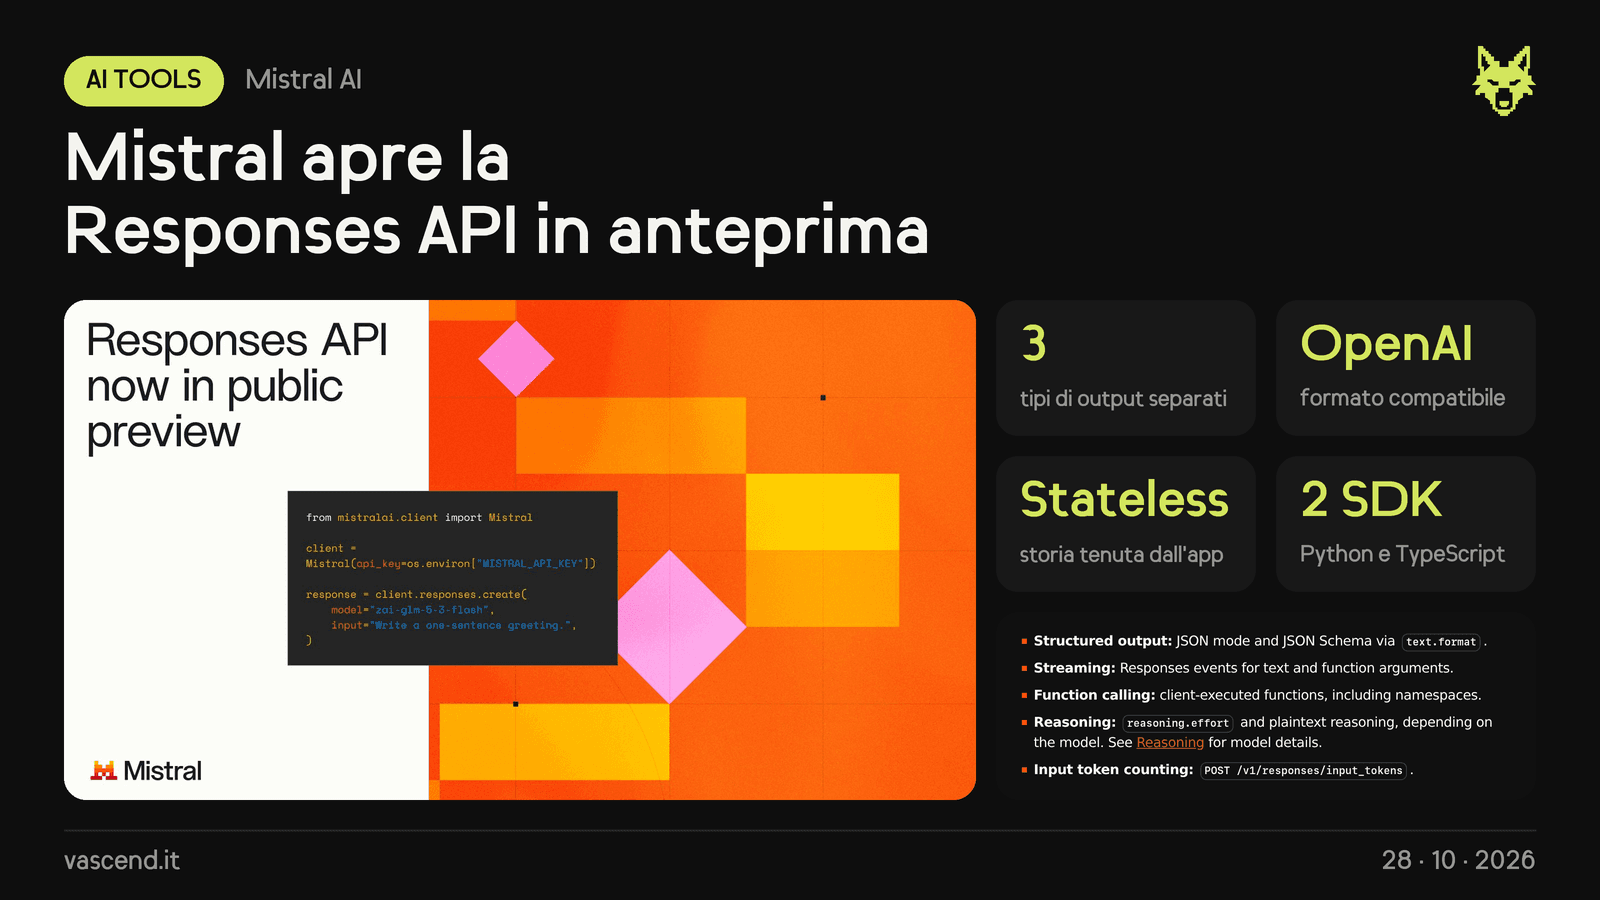
Mistral AI ha aperto in anteprima pubblica la Responses API, un nuovo endpoint pensato per costruire agenti sui suoi modelli. Segue il formato Responses di OpenAI: ogni risposta restituisce come elementi separati il testo del modello, il suo ragionamento e le chiamate agli strumenti. Secondo Mistral funziona con tutti i modelli di chat che ospita, compreso Mistral Large 4.
Come è fatta una risposta
- Ogni risposta contiene un array
outputcon elementi distinti: i messaggi del modello, il suo ragionamento e le chiamate di funzione. - L'app può così trattare ogni passo dell'agente per conto suo: mostrare il ragionamento, eseguire una funzione, consegnare la risposta finale. Secondo Mistral è più semplice che con Chat Completions.
- Il formato è quello della Responses API di OpenAI: va bene sia per un progetto nuovo sia per portare su Mistral un'integrazione Responses già esistente.
- L'indirizzo è
api.mistral.ai/v1/responses, con gli SDK Python (mistralai) e TypeScript (@mistralai/mistralai) oppure con cURL.
Niente stato sul server
- L'API è stateless: non salva le conversazioni. L'app tiene la storia e la rimanda a ogni richiesta, insieme agli elementi
outputdelle risposte precedenti. - Per questo
previous_response_ideconversationnon si usano,storeresta spento e non c'è la modalitàbackground: la risposta si genera durante la richiesta. - La storia non viene tagliata in automatico: l'input deve stare nella finestra di contesto del modello.
- Chi vuole la storia salvata da Mistral ha già l'API Conversations, che la tiene sul server con un
conversation_id.
Cosa si può fare nell'anteprima
- testo in ingresso e in uscita, come stringa o lista di messaggi
- immagini (URL o base64) con i modelli che hanno la visione
- file: URL HTTPS, base64 o ID di file già caricati
- output strutturato: modalità JSON e JSON Schema
- streaming degli eventi, sia per il testo sia per gli argomenti delle funzioni
- function calling: il modello chiede, l'app esegue la funzione e rimanda il risultato con lo stesso
call_id; le funzioni si possono raggruppare in namespace - ragionamento regolabile con
reasoning.effort, nei modelli che lo supportano e con i livelli che ognuno accetta - conteggio dei token in ingresso con
POST /v1/responses/input_tokens, per sapere quanto pesa una richiesta prima di mandarla
Gli strumenti sono solo funzioni definite ed eseguite dall'app: nell'elenco dei tool non ci sono strumenti già pronti lato Mistral.
I modelli
- Gli esempi della documentazione usano mistral-large-4 con ragionamento alto e un massimo di 4.096 token in uscita.
- Large 4 è in anteprima dal 6 ottobre: modello multimodale open-weight Mixture-of-Experts da 1,05T parametri (52B attivi) con 1M token di contesto. I pesi sono annunciati come "in arrivo".
- Nell'immagine dell'annuncio l'esempio usa invece GLM 5.3 Flash di Z.ai, che Mistral ospita dal 22 ottobre: la nuova API vale anche per i modelli di altri laboratori presenti sulla piattaforma.
Cosa significa
Mistral adotta lo stesso formato di OpenAI: chi ha già scritto codice per la Responses API può provare i modelli di Mistral con meno lavoro, senza cambiare il modo in cui gestisce messaggi, ragionamento e strumenti. Per ora è un'anteprima essenziale: niente stato sul server e niente strumenti integrati. La documentazione non indica un prezzo a parte per la nuova API, e Mistral chiede di segnalare problemi e feedback al supporto.