Community
Baidu lancia Unlimited OCR 2: documenti interi in una sola passata
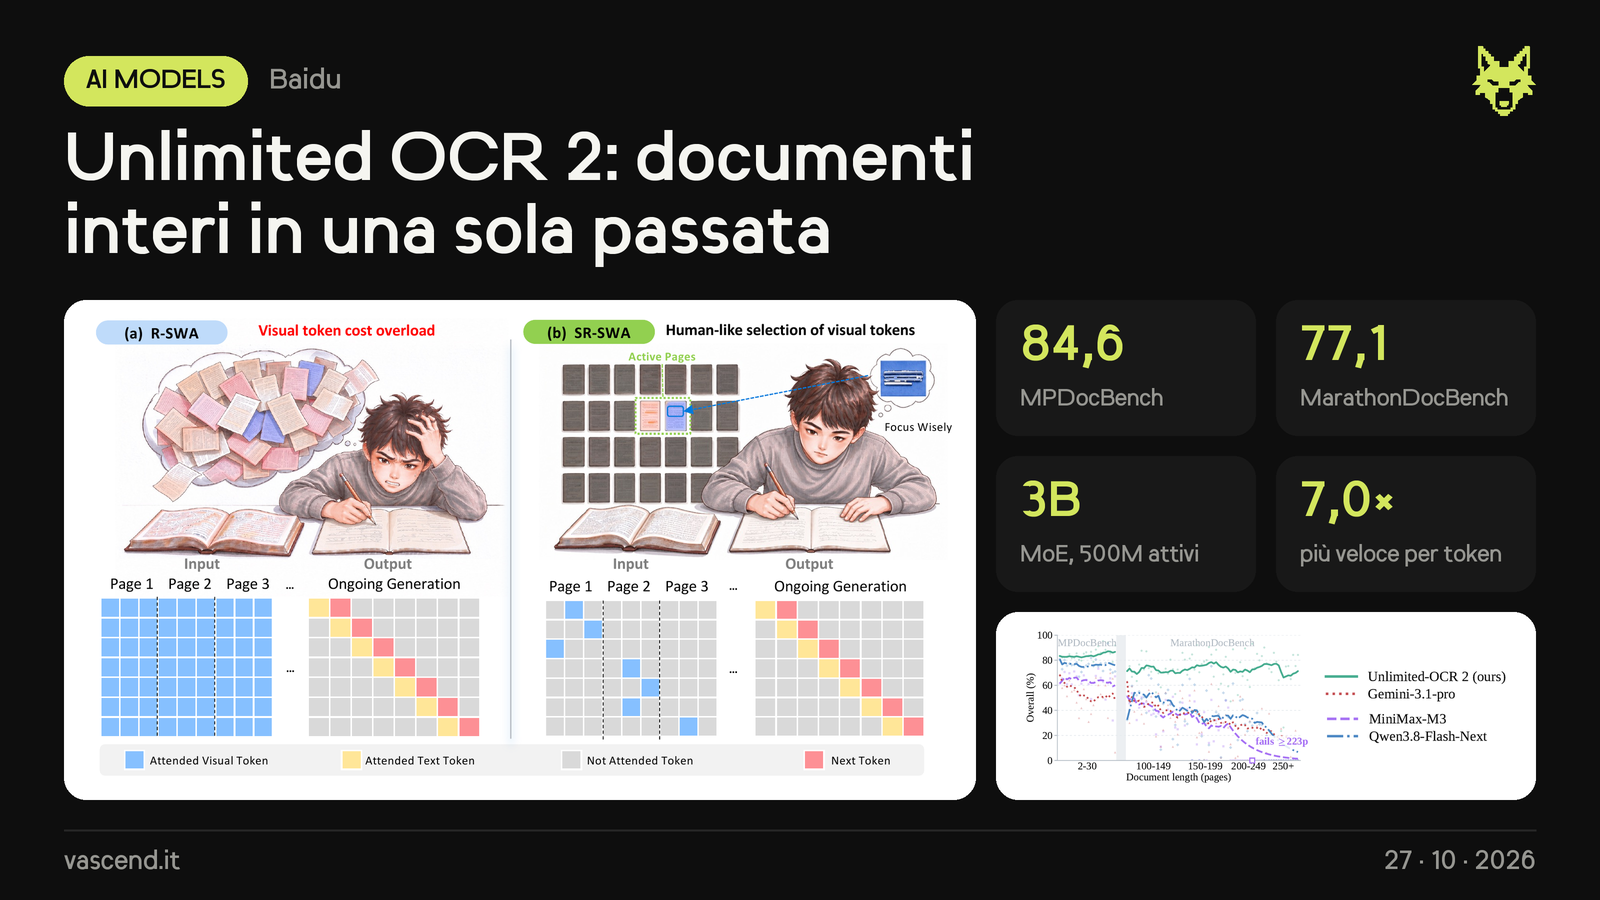
- Unlimited OCR 2 è il nuovo modello open source di Baidu (licenza MIT) che trascrive documenti lunghissimi in un'unica richiesta (testo, tabelle, formule, figure), ricucendo i blocchi spezzati fra due pagine.
- È piccolo: 3B parametri totali in un MoE con circa 500M attivi per token, costruito su DeepSeek-OCR e sul primo Unlimited OCR di giugno, che si fermava a 40 pagine.
- La novità è SR-SWA (Sparse Reference Sliding Window Attention). Invece di guardare tutte le pagine già lette, sceglie quelle utili (Page Gate) e pochi blocchi di token visivi (Token Sieve): un insieme fisso di riferimenti (es. 512 token).
- Memoria e tempo per token restano quasi costanti: a 100 pagine ogni passo è 7,0× più veloce dell'attenzione piena.
- Lavorando a blocchi di pagine, la cache KV di picco scende da 47 GB a 1,77 GB.
- Su MPDocBench (fino a 30 pagine) fa 84,6 contro 78,3 di Qwen3.8-Max; su MarathonDocBench (100 documenti da 103 a 300 pagine, nuovo benchmark di Baidu) fa 77,1: il migliore degli altri, Kimi-K3, si ferma a 33,7, Gemini-3.8-Flash a 28,6.
- Nella demo di Baidu legge un PDF di Harry Potter da 3.623 pagine in una sola richiesta. Gira con Transformers o SGLang; limite ammesso dagli autori: la gerarchia dei titoli.